
Qwen3-0.6B 医疗 SFT 实战:从 SwanLab 曲线里读出过拟合信号
经验驱动。这是一次跑完就算完的训练复盘:Qwen3-0.6B 在 2166 条医学问答上做 SFT,一共跑了 5 次,曲线全部留在 SwanLab 上。本文所有数字都来自那 5 次真实运行——包括一次被手动中断的、一次上传不完整的。真正有价值的发现只有一句话:train loss 一路降到 0.5,eval loss 却在 step 1000 触底后反弹了 0.14。
一、这次训练到底在干什么
把 Qwen3-0.6B 微调成一个”医学专家”:给它一个问题,它要先输出思考过程(think 字段),再给答案(answer 字段)。所以标签不是简单的答案,而是 think + answer 拼起来的一段文本。
硬件是 RTX 5070 Ti Laptop,12G 显存。这个显存量决定了后面一连串妥协:max_length 只能开到 1024,必须开 gradient_checkpointing,batch size 只能按 1 来。
| 项目 | 值 |
|---|---|
| 基座模型 | Qwen3-0.6B(本地加载) |
| 训练样本 | train.jsonl 2166 条 |
| 验证样本 | val.jsonl 241 条 |
| 最大长度 | 1024(12G 显存逼的) |
| epoch | 3 |
| batch size | 1 × 梯度累积 4 = 有效 batch 4 |
| 学习率 | 1e-4,cosine,warmup 100 步 |
| 精度 | bf16 + gradient_checkpointing |
| 验证策略 | 每 200 步一次,metric_for_best_model="eval_loss" |
| 最优模型 | load_best_model_at_end=True |
每 epoch 是 2166 / 4 ≈ 542 步,3 个 epoch 一共约 1626 步——这正好和 SwanLab 曲线上最后一个 step 1600 对得上。
二、5 次运行的真实战绩
同一个项目 qwen3-sft-medical 下面一共 5 个 run。我把它们的状态全列出来,包括失败的,因为失败的那两次本身就是信息:
| Run | 状态 | epoch | 记录到的 train loss | eval loss | 总时长 | 吞吐 |
|---|---|---|---|---|---|---|
quick-swan-0 | 完成 | 1 | 1.763 → 1.583 | 1.565(step 542) | 347 s | 1.56 步/s |
slow-rat-1 | 被中断 | 3 | 1.763 → 1.087 | 1.711(step 500) | — | — |
small-ox-2 | 完成 | 3 | 1.763 → 0.474 | 1.557 → 1.754 | 1108 s | 1.47 步/s |
large-tiger-3 | 完成 | 3 | 1.698 → 0.500 | 1.385 → 1.525 | 2037 s | 0.80 步/s |
young-rabbit-4 | 完成 | 3 | 1.698 → 1.630 | 1.622(step 400) | — | — |
young-rabbit-4 那次比较特殊:它显示”完成”,但只上传到 step 400 的数据,single_value/* 汇总指标一个都没有。这种”状态说完成、数据却是半截”的情况,只看状态栏是发现不了的,得点进曲线看一眼最后停在哪。
三、核心图:train loss 在降,eval loss 在反弹
这是整篇文章最重要的一张图。两个完整跑完 3 epoch 的 run,实线是 train loss,虚线是 eval loss:
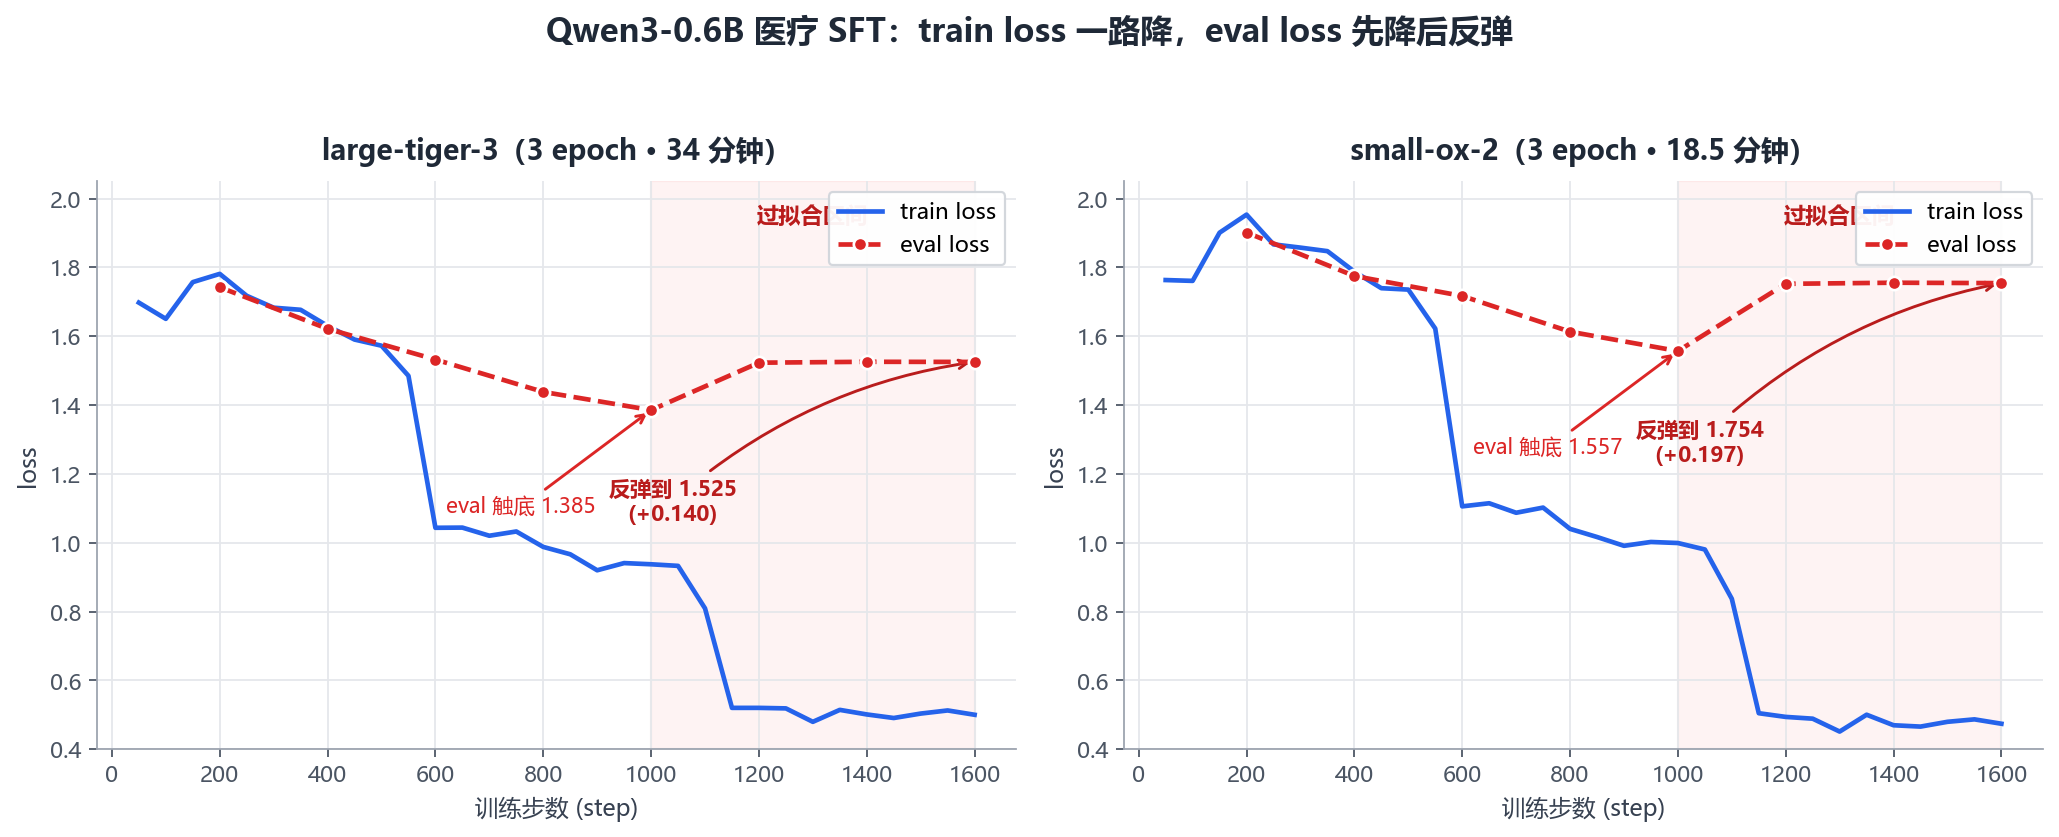
两个 run 的形状几乎一样,而且都不是”一路下降”的健康曲线:
- step 1000 之前:train loss 和 eval loss 一起降,这是正常的”都在学”阶段。
large-tiger-3的 eval loss 在 step 1000 触底 1.385。 - step 1000 之后:train loss 继续从 1.4 一路砸到 0.50,eval loss 却掉头往上爬,最后回到 1.525(涨了 0.140)。
small-ox-2更明显:eval loss 从 1.557 反弹到 1.754(涨了 0.197)。
这就是过拟合的标准长相:模型开始死记训练集,泛化能力反而在退化。train loss 越低,不代表模型越好——这个案例里 train loss 降了 0.9,eval loss 反而恶化了 0.14。
一个被配置救了的细节
回头看训练参数,这两行是对的:
1 | load_best_model_at_end=True, |
因为指定了按 eval_loss 取最优,Trainer 会把 step 1000 那个 eval loss = 1.385 的 checkpoint 留下来,而不是最后那个过拟合的。曲线反弹不等于白跑——但前提是你得告诉它按什么指标留。如果当时偷懒写成 load_best_model_at_end=False,拿到的就是末尾那个已经开始退化的模型。
四、另外两张曲线在说什么
学习率调度。三次运行共用同一份 warmup + cosine,峰值 1e-4,尾部衰减到 7.7e-8:
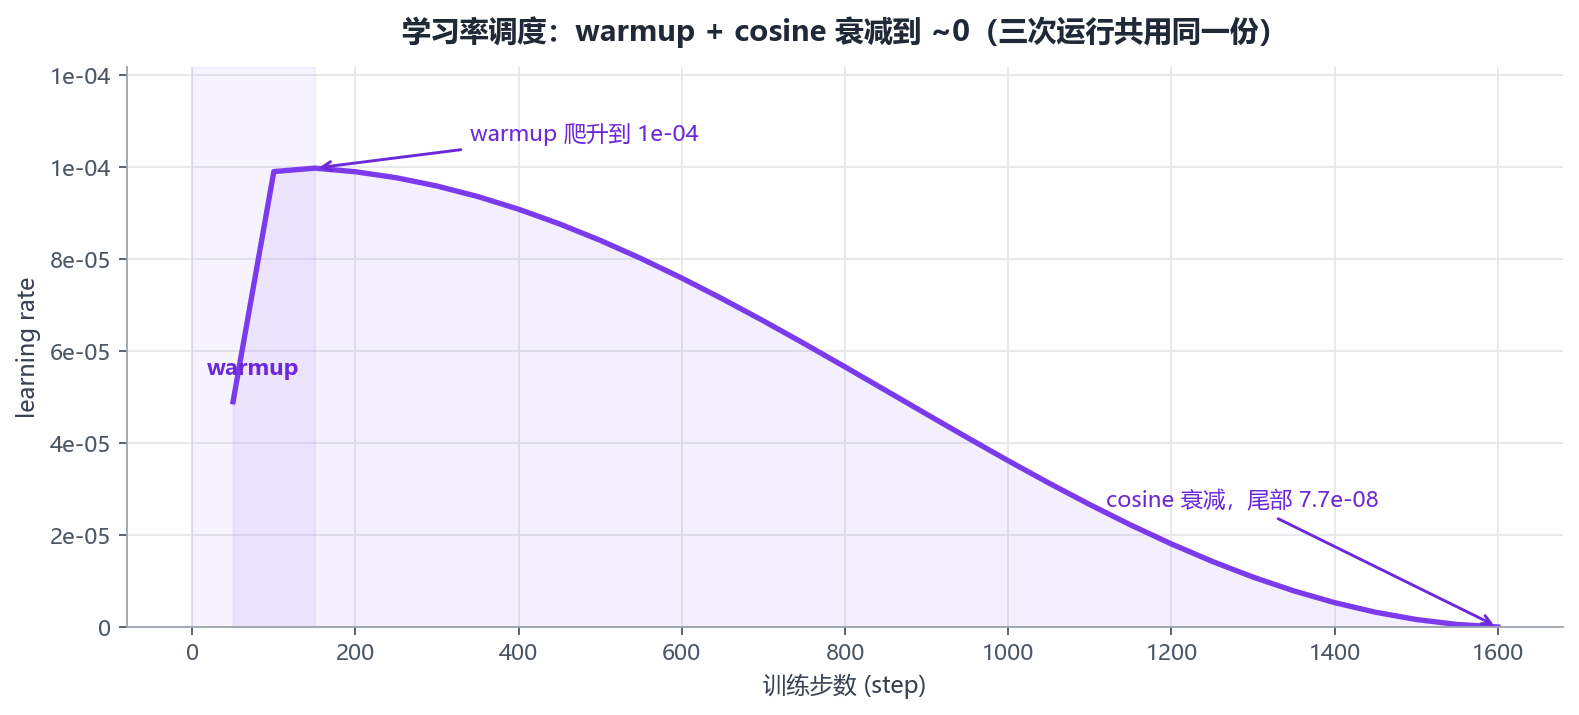
这里有个容易看错的点:曲线尾部压到接近 0,会让人以为”训练后期基本没在学了”。但实际上 eval loss 的反弹恰好发生在学习率还很高的 step 1000–1200 区间。学习率衰减解决的是收敛稳定性,治不了过拟合。
梯度范数。开局冲到 8.25,200 步内掉到 6 以下,之后稳定在 4~6:
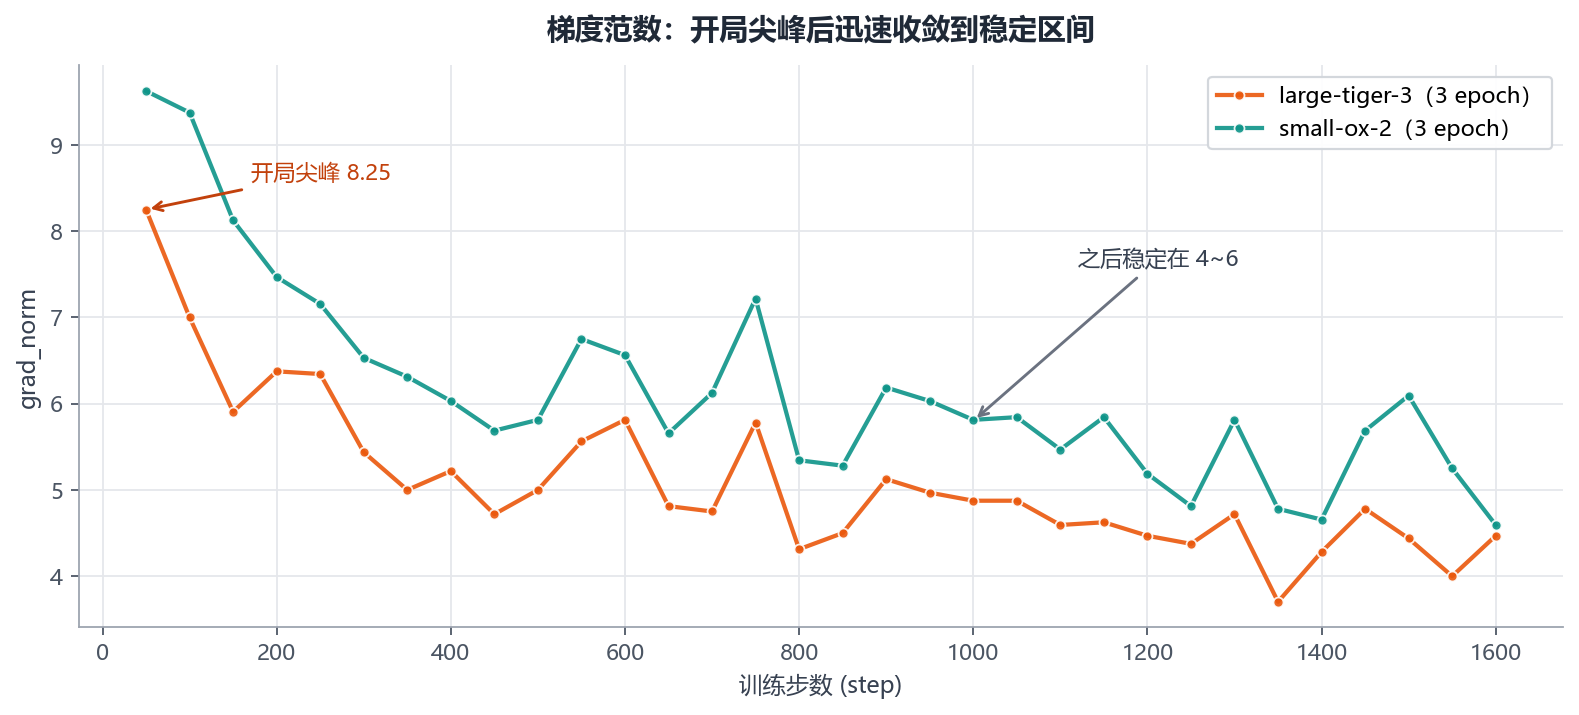
开局尖峰是正常的(预训练权重刚换成新数据分布),但如果尖峰出现在训练中后段,那就是数据里有脏样本或者学习率过大。这条曲线没有这个问题。
五、同一份配置,三次运行差多少
这是我觉得最值得贴出来的一张图——同样的代码、同样的数据、同样的超参,只是跑了三次:
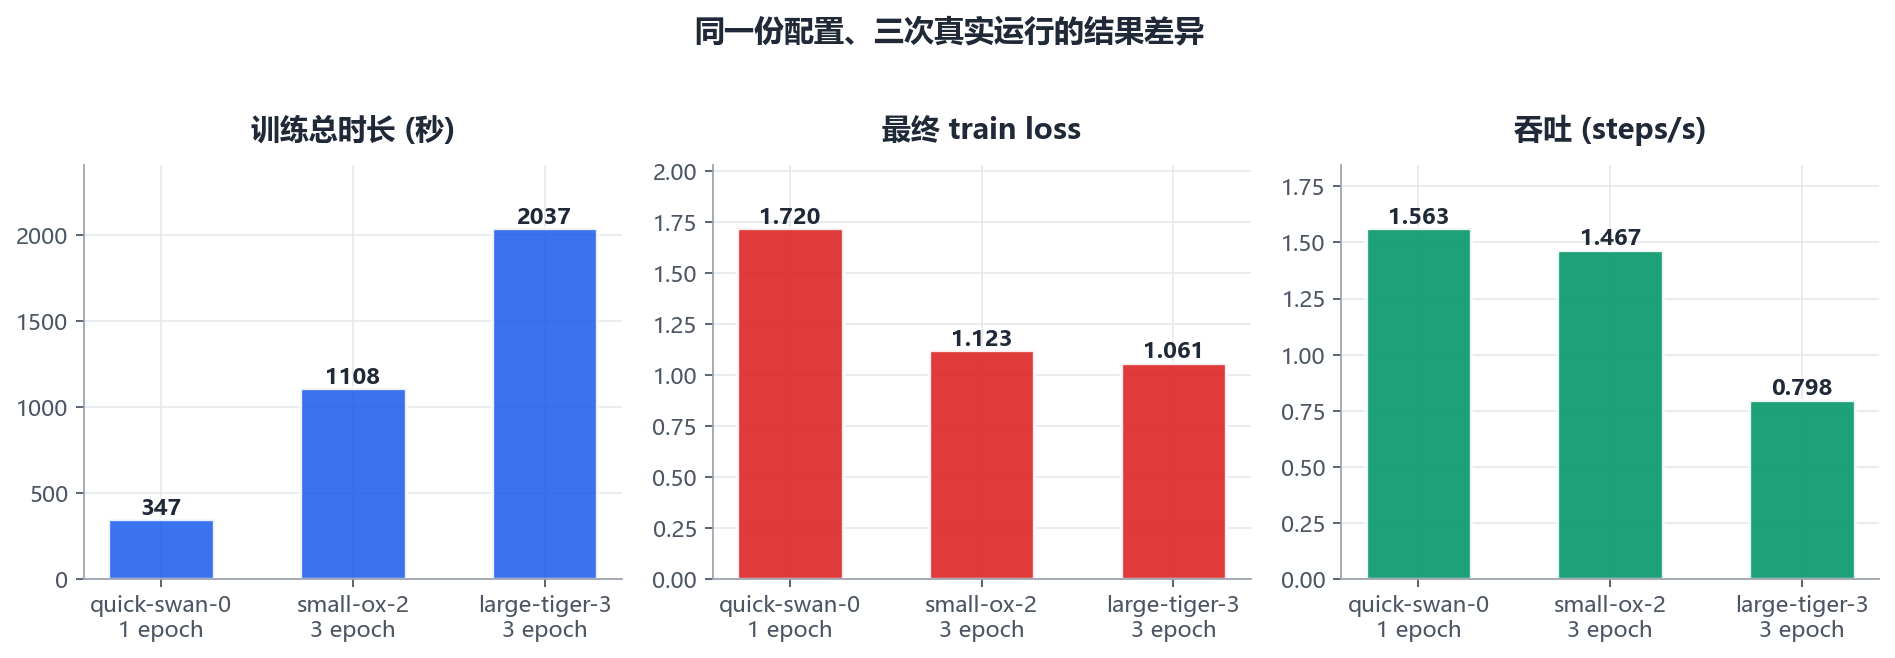
- 总时长:347 s(1 epoch)→ 1108 s → 2037 s。注意
small-ox-2和large-tiger-3都是 3 epoch,时长差了 1.85 倍(1108 vs 2037)。 - 最终 train loss:1.720 → 1.123 → 1.061。
- 吞吐:1.56 → 1.47 → 0.80 步/s。那个 0.80 的 run 慢得多,但 loss 也最低。
时长差 1.85 倍这件事,我没有继续深挖——可能是当时机器上还压着别的东西(这台机器日常同时跑聊天模型和 agent),也可能是两次运行的 GPU 频率/温度策略不同。但它提醒一件事:训练时长这个指标,在共享机器上噪声极大,不适合当硬指标看。
六、这次复盘学到的四件事
- 别只看 train loss 报喜。train loss 从 1.7 降到 0.5 看着很爽,但 eval loss 在 step 1000 就掉头上去了。判断模型好坏的是 eval 曲线,不是 train 曲线。
- eval loss 反弹时,先查是不是该早停了。这个案例里 3 个 epoch 明显多了,第 2 个 epoch 末(step ~1084)就是合理终点。要么设
EarlyStoppingCallback,要么直接把 epoch 降到 2。 load_best_model_at_end+metric_for_best_model是保险丝。配错了指标或者忘了开,过拟合的那部分就直接进最终模型了。- 状态栏说”完成”不代表数据完整。
young-rabbit-4显示完成,实际只上传到 step 400。验收要看曲线终点,不要只看状态。
七、下一步该改什么
按优先级排:
- epoch 3 → 2:eval loss 在 step 1000 触底,对应约 1.85 个 epoch,第 3 个 epoch 纯属过度训练。
- 加早停:
EarlyStoppingCallback(early_stopping_patience=2),让 eval loss 连续 2 次不降就自动停,比手猜 epoch 数稳。 - 验证集太小:241 条算出来的 eval loss 噪声不小(相邻两次验证能差 0.15)。有条件就扩到 500+ 条。
- 换更大基座或上 LoRA:0.6B 全参微调在这个任务上已经到顶,想再往上只能换模型或者换微调方式。
关于本文数据:所有曲线和数字来自 SwanLab 项目 qwen3-sft-medical(用户名 love)下的 5 次真实运行,通过 SwanLab 公开 API 拉取原始 metric 后用 matplotlib 重绘,未做任何平滑或修饰。训练脚本为 226 行的 train.py,基于 🤗 transformers Trainer + report_to="swanlab"。


