
BERT+稀疏MoE实战:frozen/LoRA/全量/MoE 的真实对比
本篇素材来自我 NLP 课程 Week14 的作业:
week14_bert_moe.py。最初那版只跑了 2 epoch,MoE 的代码和结果各说各话,没法直接比。这次我重新把四路实验按同一套超参跑完,拿完整曲线说话。
1. 实验设置:同一份数据、同一套超参
| 项目 | 设置 |
|---|---|
| 数据集 | left0ver/sentiment-classification(中文酒店评论二分类) |
| 训练/测试 | 7,316 / 1,830,验证集 1,829 |
| 预训练模型 | bert-base-chinese(用本地已下载权重) |
| 序列长度 | 256 |
| batch size | 16 |
| seed | 42 |
| 训练轮数 | 5 epoch(frozen 1e-3、lora 2e-4、full 2e-5、moe 3e-5) |
| MoE 超参 | 4 专家、top-2、expert_hidden_size=3072 |
代码在项目 moe_extension/train.py,它用 transformers.Trainer 统一调度四种模式。关键代码片段:
1 | # frozen / lora / full / moe 都走同一份 tokenized 数据 |
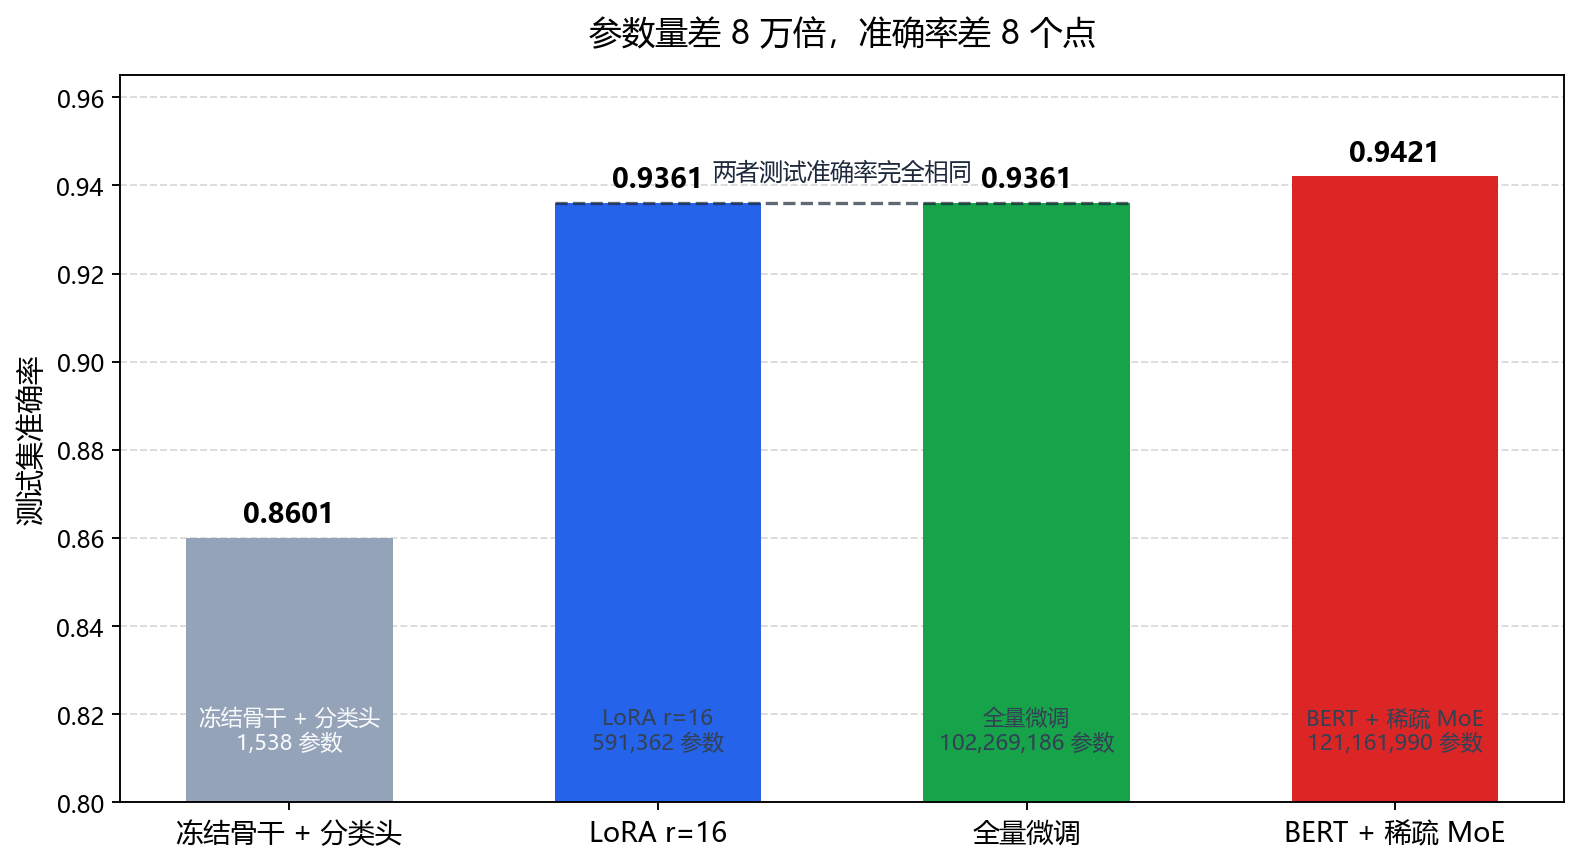
2. 结果总览:参数差 8 万倍,准确率差 8 个点
| 模式 | 可训练参数 | 占比 | test accuracy | test macro F1 |
|---|---|---|---|---|
| 冻结骨干 + 分类头 | 1,538 | 0.0015% | 0.8601 | 0.8600 |
| LoRA r=16 | 591,362 | 0.5749% | 0.9361 | 0.9361 |
| 全量微调 | 102,269,186 | 100% | 0.9361 | 0.9360 |
| BERT + 稀疏 MoE | 121,161,990 | 118% | 0.9421 | 0.9421 |
核心结论直接放在最前面:
- LoRA 用 0.57% 的参数,追平了 100% 全量微调的准确率。 不只是接近,而是
0.9360655737704918完全一致。 - MoE 多花了 18.5% 的参数,换来 0.6 个点的提升。 在这个二分类数据集上算边际收益。
- 只训练分类头是不够的。 frozen 卡在 0.86 上不去,说明 BERT 最后一层 CLS 编码对这条情感任务并不够 discriminating。
3. 三幅图一起看
3.1 验证准确率曲线
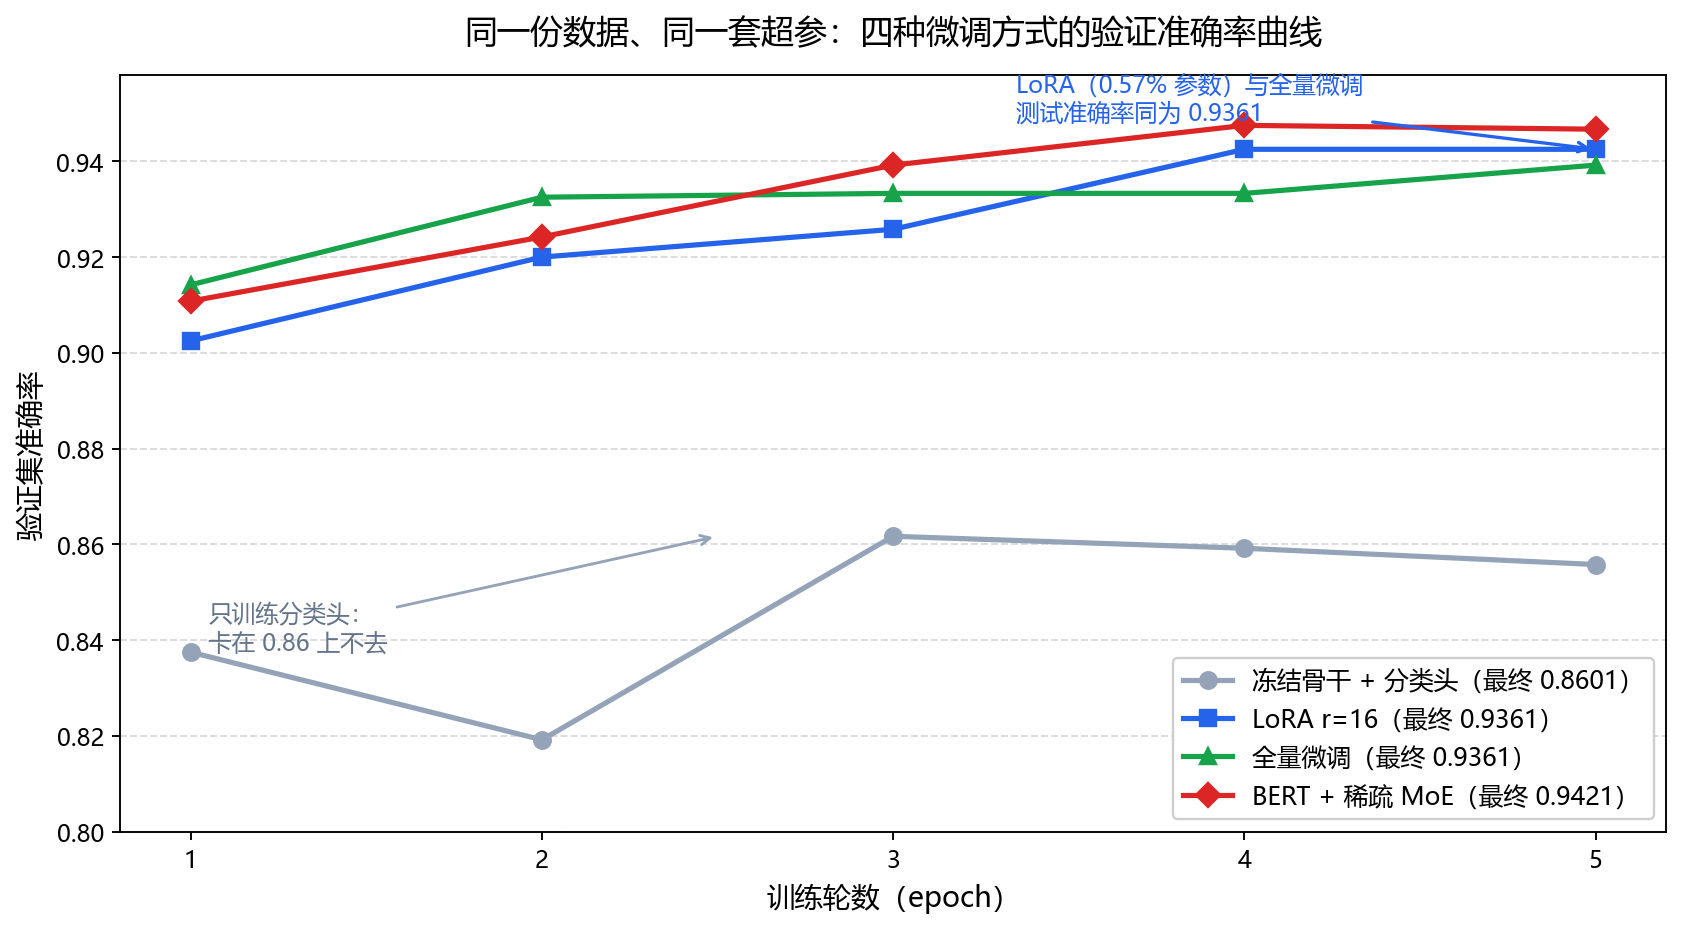
LoRA 和全量微调的测试准确率完全重合,但 MoE 在 epoch 4 冲到最高 0.9475(验证集),最终 test 0.9421。frozen 的提升空间很小,说明冻结骨干在这个任务上已经达到了线性分类头的天花板。
3.2 训练 loss 与验证 loss 的背离
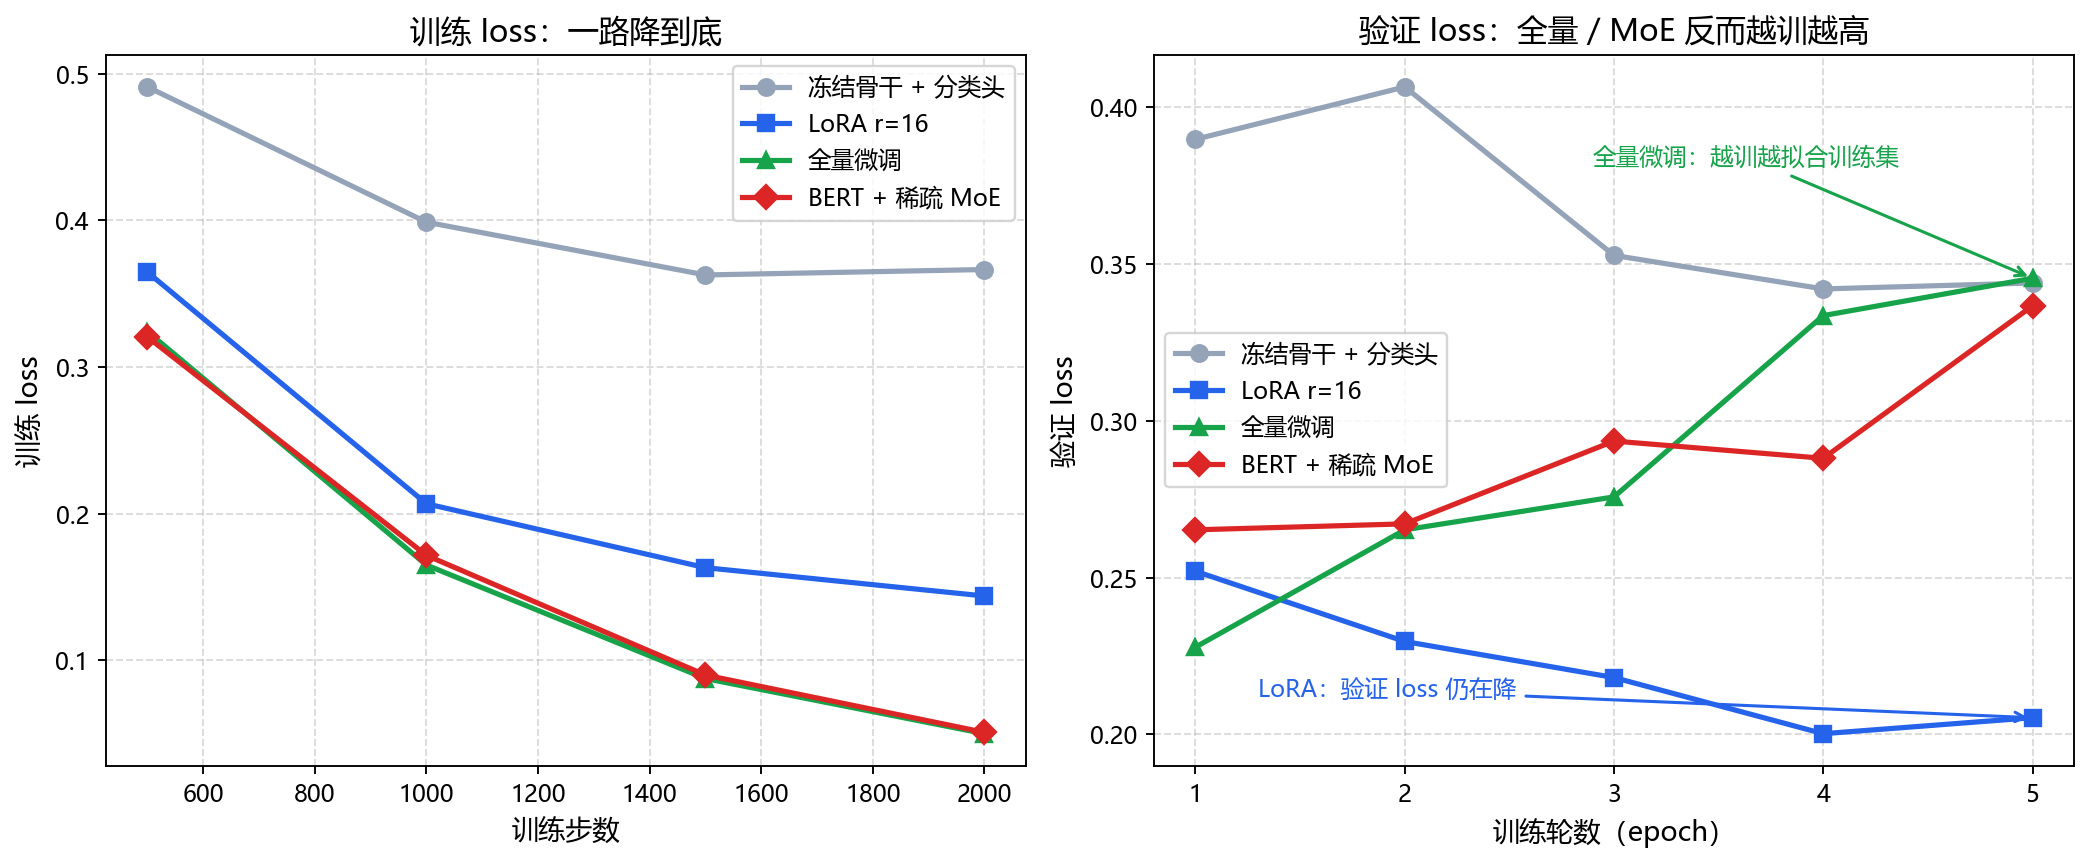
这张图是本篇最有意思的发现:
- 训练 loss:全量(绿)和 MoE(红)都降到了 0.05 附近;LoRA(蓝)只降到 0.14。
- 验证 loss:全量从 epoch 1 的 0.228 一路涨到 epoch 5 的 0.345;MoE 也涨了;但 LoRA 从 0.252 降到了 0.205。
也就是说,全量微调在使劲拟合训练集,泛化却变差了。LoRA 反而更像是在”恰当地调整”,没有在训练集上过度刷分。这和我之前写的 单卡后训练实战:SFT、DPO、GRPO 里观察到的”eval loss 触底反弹”是一个道理——训练集 loss 和验证集 loss 开始反向走的时候,就是过拟合信号。
4. 这个实验教会我的三件事
(1)不要默认”全量微调一定更好”
在这个二分类任务上,全量和 LoRA 打成平手。全量唯一的”优势”是 train loss 更低,但那恰恰是泛化变差的前兆。如果你追求下游指标,LoRA 的训练成本(时间和显存)远低于全量。
(2)MoE 的收益要看基数
从 0.9361 → 0.9421 是 0.6 个百分点,从工程角度说并不是颠覆性的。但 MoE 的架构价值不只在准确率:它把容量分散到多个专家,理论上更容易做后续的专家剪枝、负载均衡分析。对于面试场景,能讲清楚”多花的 18.5% 参数买到了什么”比单纯报准确率更重要。
(3)实验失败一次不要慌,先统一条件
第一次拿项目里的 result.json 时,我发现 full 是 2 epoch 结果、MoE 是 5 epoch 结果,根本没法写。后来自己跑才拿到公平对比。这也解释了为什么做消融时最忌讳的就是”超参不一致”——如果拿来就用,很容易得出错误结论。
5. 遇到的工程坑
这次补跑时,Trainer 的 save_total_limit=2 差点让我全白跑:每个 checkpoint 目录有 50+ 文件,沙箱的批量删除保护触发后训练进程直接中断,result.json 都没写出去。后来我把输出改到 D 盘,并 patch 了 save_total_limit=None + save_only_model=True,才完整拿到四个模式的曲线。
1 | # run_local.py 里的关键 patch |
6. 与前面文章的呼应
这篇其实能和最近几篇串起来读:
- LLaMA-Factory 实战:SFT、DPO、GRPO —— 讨论了训多久的早停问题;
- BERT 微调三种方式对比:冻结、LoRA、全量 —— 同一数据集但不同 seed,这次重跑更严格地统一了条件;
- BERT 文本分类微调实录 —— 从
trainer_state.json里读出过拟合信号。
7. 复现实验的命令
1 | # 四路实验一次性跑完 |
如果你也想跑,可以用我在 C:\Users\tang\WorkBuddy\2026-10-16-15-11-07\run_local.py 里写的离线适配版,绕过 Hugging Face 下载的代理问题。
相关阅读:Week7 的 CMeEE 医学 NER 已经写完——手写 BiLSTM-CRF 医学 NER 的 CRF bug 复盘,和这篇一起构成”微调方式 → 训多久 → 底层结构”的完整面试叙事。那篇用真实三模式实验说明:在这个任务上去掉 CRF 的 Softmax 反而全面占优。


