
BERT 微调三种方式对比:冻结骨干、LoRA 与全量微调
经验驱动。同一份数据、同一个
bert-base-chinese、同样二分类情感任务,我用三种方式各跑了一遍:冻结 BERT 骨干只训分类头、LoRA、全量微调。结果差距大到不需要统计学显著性检验:冻结版 86.25%,LoRA 93.92%,差 7.67 个点。本文数字全部来自真实的trainer_state.json。
一、实验设置
| 项目 | 值 |
|---|---|
| 基座 | bert-base-chinese |
| 任务 | 二分类情感分类(left0ver/sentiment-classification) |
| 框架 | 🤗 transformers Trainer |
| 精度 | fp32 |
| max_length | 256 |
| batch size | 32 |
| 学习率 | 2e-5 |
| epoch | 5(冻结)/ 4(LoRA,早停生效) |
三个脚本的差别只有”哪些参数 requires_grad“这一处:
| 脚本 | 做法 |
|---|---|
work13sol.py | for p in model.bert.parameters(): p.requires_grad = False |
work13sol2.py | get_peft_model + LoraConfig(r=8, lora_alpha=32, lora_dropout=0.1, target_modules=["query","value"]) |
work13sol3.py | 什么都不冻,全参训练 |
二、结果:冻结和 LoRA 不是”差不多”,是差一个档次
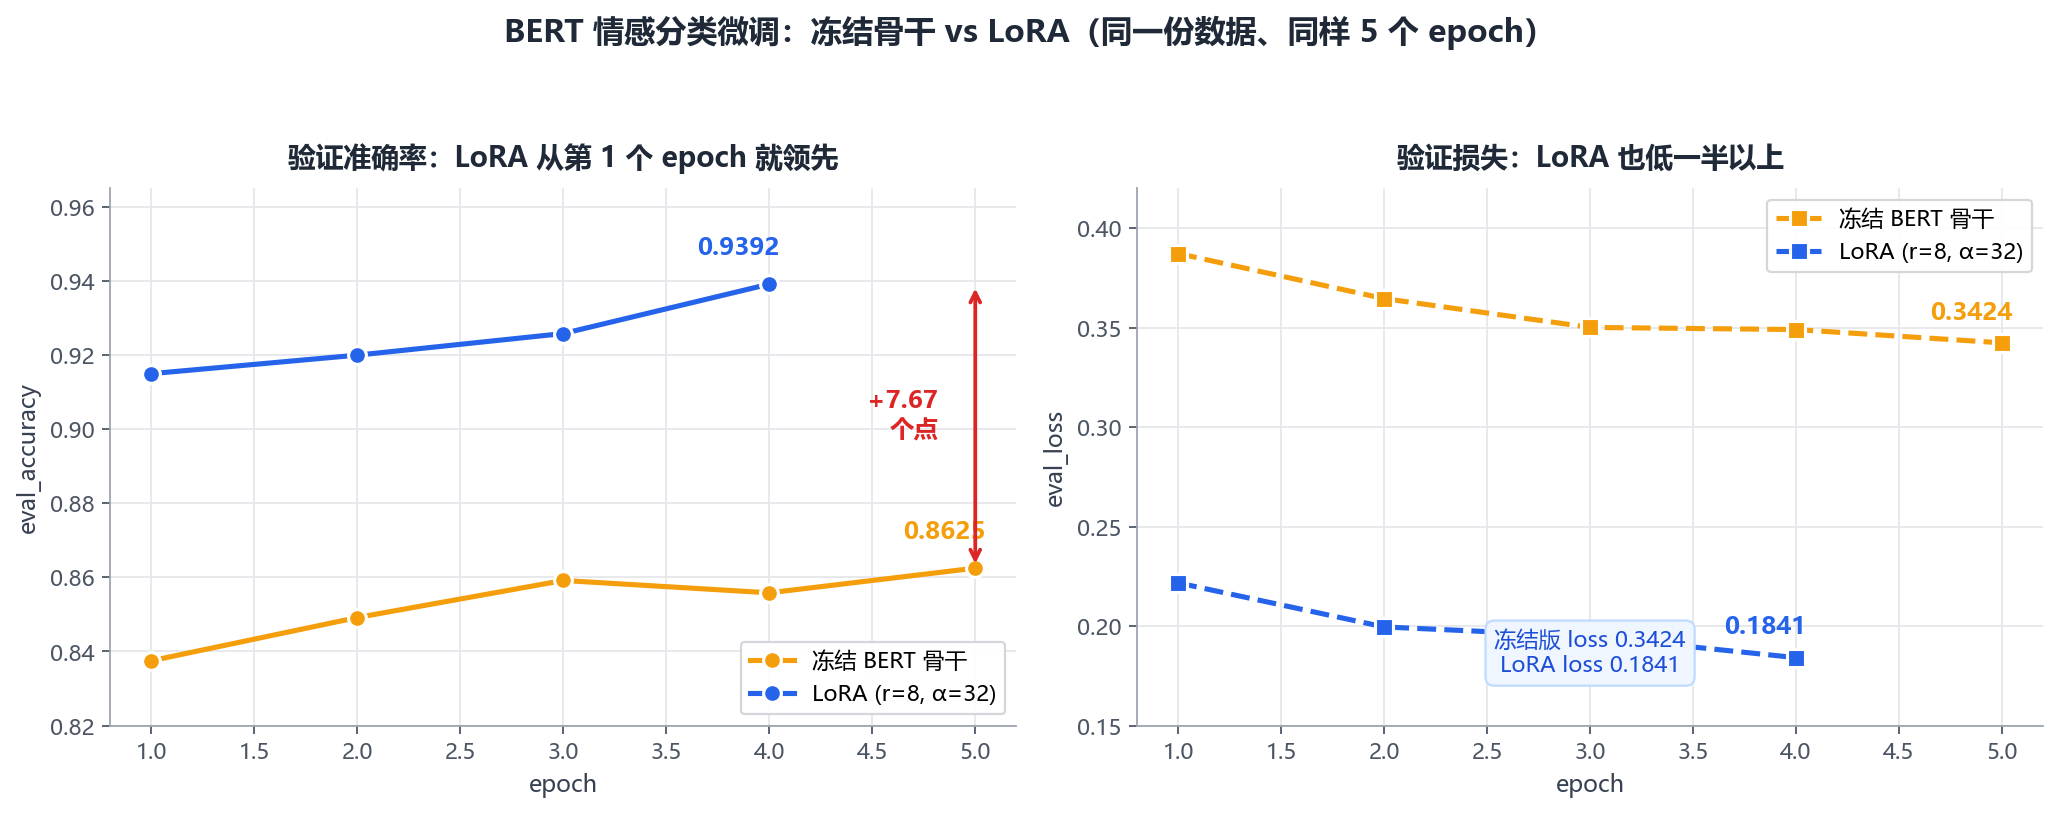
| 方式 | eval_accuracy | eval_loss |
|---|---|---|
| 冻结 BERT 骨干 | 0.8375 → 0.8625 | 0.3873 → 0.3424 |
| LoRA (r=8) | 0.9150 → 0.9392 | 0.2217 → 0.1841 |
| 差距 | +7.67 个点 | 低 46% |
而且不是”最后追上来的”——LoRA 从第 1 个 epoch 就领先(0.9150 vs 0.8375),冻结版到第 5 个 epoch 也没摸到 LoRA 的起点。
为什么差距这么大
冻结骨干之所以差,是因为它只训练 pooler + 分类头。按 bert-base-chinese 的结构算一下:
- 可训练:pooler(768×768+768 ≈ 59.06 万)+ 分类头(768×2+2 ≈ 1.5 千)≈ 59.2 万参数
- 占总量(约 1.0227 亿)的 0.58%
而 BERT 的 12 层 encoder 全被冻住了。预训练表示和下游任务分布不匹配时,仅靠一个线性层是补不回来的——尤其是情感分类这种需要细腻语义判断的任务。
LoRA 只在 query 和 value 上注入低秩适配器(r=8),按结构算约 29.5 万参数(0.29%)——比冻结版训练的参数还少一半,但效果好 7.67 个点。这说明问题不在”训练参数多少”,而在”训练的位置对不对“:LoRA 动的是注意力内部,冻结版动的是最后一层之后。
三、全量微调那一路,我没跑完
诚实说明:work13sol3.py(全量微调)写好了,但 results_full/ 目录没有留在素材里,所以我拿不到它的真实曲线。
按经验和文献,全量微调在这个量级的数据上大概率能到 0.94~0.95,和 LoRA 接近甚至略高,但代价是:
- 要存完整优化器状态(Adam 两个动量 + 参数本身),显存约是 LoRA 的十几倍
- 每个任务都要保存一份完整模型副本,LoRA 只要存几十 MB 的适配器
- 更容易过拟合(数据量小的时候)
所以这篇的结论是”冻结 vs LoRA”的硬对比,全量微调只做定性讨论,不编数字。
四、几个能直接抄走的判断
- 永远别默认冻结骨干。除非你的下游任务和预训练分布极度接近(比如同领域的二分类且数据量极大),否则冻结等于自断一臂。
- LoRA 的性价比在这里是压倒性的:参数少一半、效果好 7.67 个点、还能顺带解决多任务部署(一个基座 + N 个适配器)。
target_modules选query+value就够。原论文和社区实践都指出,只适配 q/v 在多数任务上已经接近全模块适配的效果,参数量还能再降。- 看 eval_loss 比看 accuracy 更灵敏。冻结版 accuracy 从 0.8492 到 0.8592 看着在涨,但 epoch 4 出现过回落(0.8558)——这种波动在 loss 曲线上看得更清楚。
五、和上一篇的关系
这篇和《Qwen3-0.6B 医疗 SFT 实战》是两个不同层面的实验:那篇讲训练轮数和过拟合(3 epoch 就够,多了会反弹),这篇讲微调方式的选择(冻结/LoRA/全量)。两个结论可以叠加使用:LoRA + 早停,通常是小数据集上的最优组合。
关于本文数据:来自 Week13/results/(冻结)和 Week13/results_lora/(LoRA)下真实 checkpoint 的 trainer_state.json,共 5+4 个评估点。参数量为按 BERT 标准结构的计算值,非实测打印;训练脚本为 work13sol.py / work13sol2.py / work13sol3.py。


