
BERT 文本分类微调实录:从 checkpoint 里读出过拟合的另一种信号
经验驱动。这是一次
bert-base-chinese的文本分类微调,留下了两个真实 checkpoint。最有意思的地方在于:第 2 个 epoch 的准确率比第 1 个高(0.9054 → 0.9114),但验证损失也更高(0.2533 → 0.2625)。准确率和损失朝相反方向走,这说明什么?本文所有数字来自trainer_state.json的原始记录。
一、实验设置
| 项目 | 值 |
|---|---|
| 基座 | bert-base-chinese(21128 词表 / 12 层 / 768 隐层) |
| 任务 | 电商评论文本分类(BertForSequenceClassification) |
| 计划 epoch | 3(max_steps: 8442) |
| 实际停止 | 第 2 个 epoch,step 5628 |
| train batch size | 16 |
| 验证 / 保存 / 日志频率 | 每 500 / 500 / 50 步 |
| 早停 | EarlyStoppingCallback(early_stopping_patience=2) |
| 保存策略 | load_best_model_at_end,最终保留 checkpoint-5628 |
先注意一个细节:计划跑 3 个 epoch(8442 步),实际停在 5628 步,正好是第 2 个 epoch 结束。说明早停机制介入了——虽然配置里写的是 patience=2,但训练确实没有跑满。
二、核心异常:准确率升了,损失也升了
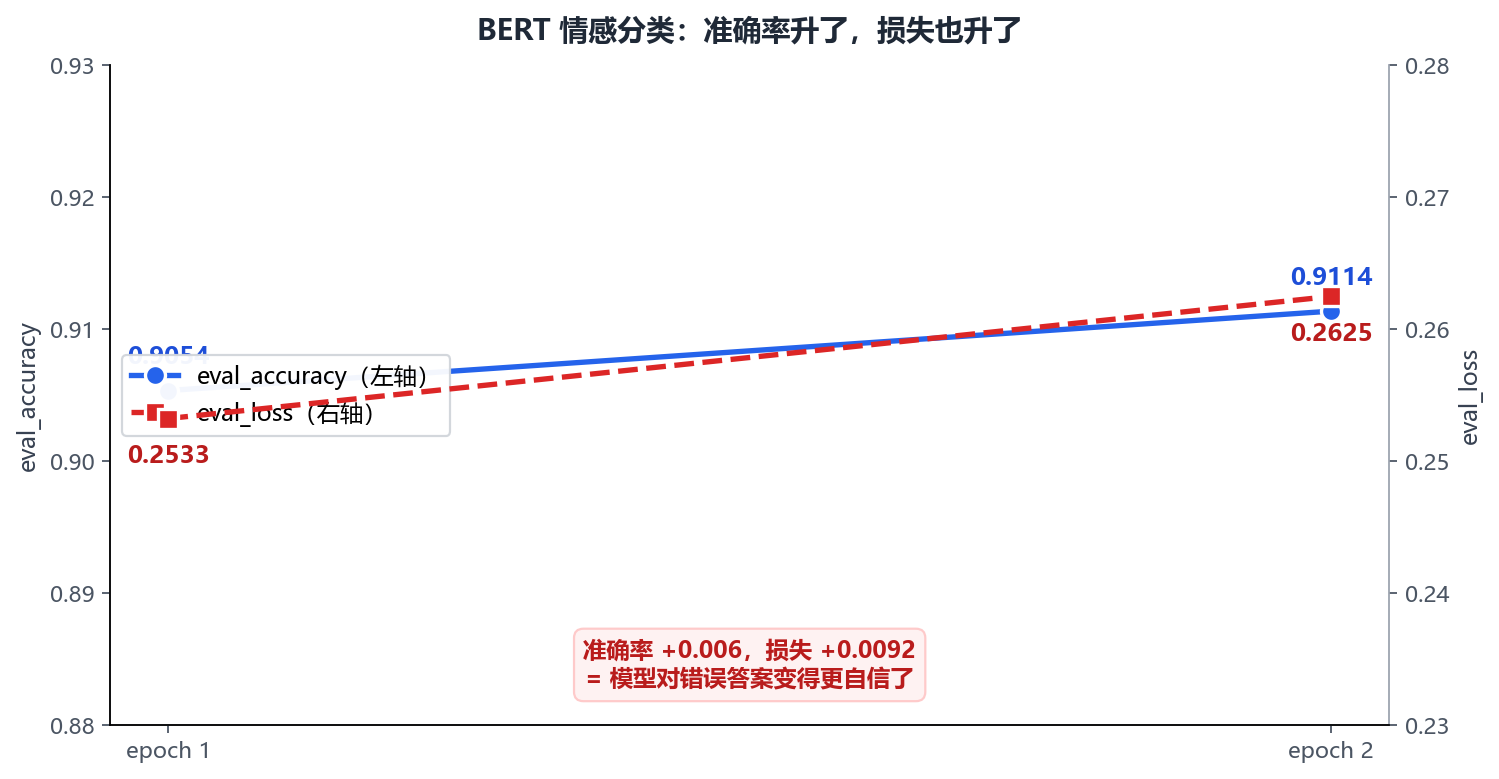
两个验证点的完整指标:
| epoch | step | eval_accuracy | eval_f1 | eval_loss |
|---|---|---|---|---|
| 1 | 2814 | 0.9054 | 0.9050 | 0.2533 |
| 2 | 5628 | 0.9114 | 0.9085 | 0.2625 |
基于 argmax 的两个指标(accuracy、F1)都在涨,但损失在涨。
这说明什么
交叉熵损失不只关心”选对没选对”,它关心概率分布的形状。所以准确率涨 + 损失涨,通常意味着:
模型把更多样本分对了,但对分错的那些样本变得更加自信了。
具体讲:epoch 1 时分错的样本,模型可能给 0.45 vs 0.55 这种接近五五开的概率,损失不大;到 epoch 2,它把一部分原本分对的样本进一步推向了正确类的极端(损失降低),但对分错的样本也敢给出 0.9 vs 0.1 了(损失暴涨)。净效果是 argmax 正确的个数略增,但总损失上升。
这是过拟合早期的一种典型形态——比”准确率下降”出现得更早。如果只看准确率,你会觉得”还在涨,继续训”;看了损失才知道,模型已经开始在训练集上过度自信了。
三、训练过程里的其他信号
训练损失早就平台化了
从 500 步之后,train loss 基本在 0.19 ~ 0.30 之间震荡,没有任何持续下降趋势:
1 | step 2650 loss 0.2172 |
第 2 个 epoch 的训练损失并没有比第 1 个更低——模型已经从训练数据里学不到新东西了。这和验证损失的上升是同一件事的两面。
梯度范数有多次尖峰
训练全程 grad_norm 大部分在 1~10 之间,但出现了几次明显尖峰:
| step | grad_norm |
|---|---|
| 900 | 54.23 |
| 3300 | 23.19 |
| 4050 | 18.59 |
| 4950 | 20.86 |
| 5100 | 21.31 |
单点尖峰(而不是持续增大)通常是个别困难样本或噪声样本造成的,不是训练不稳定。但如果尖峰频繁出现且幅度持续增长,就要检查数据里是不是有脏样本,或者考虑加梯度裁剪。
四、一个容易忽略的部署坑:config.json 没记标签
翻 checkpoint-5628/config.json 时会发现:
1 | { |
没有 num_labels,没有 id2label,没有 label2id。
这意味着:模型文件本身不告诉你 index 0 是负面还是正面。真要部署,你必须自己去训练脚本或数据里确认标签顺序,否则很容易把正负类搞反——准确率看着 0.91,实际全反了。
这是我在这次实验里踩到的实打实的坑。保存模型时一定要显式写入标签映射:
1 | model.config.id2label = {0: "负面", 1: "正面"} |
五、这次实验的四条结论
- 准确率和损失要一起看。单看准确率会漏掉”过拟合早期”这个信号。理想情况是两个都降;准确率涨但损失涨,就该警惕了。
- 早停值得配。这次 3 个 epoch 的计划实际只跑了 2 个,省下的不只是时间,更是避免了第 3 个 epoch 的进一步过拟合。
- train loss 平台化比 eval loss 上升更早出现。训练损失不再下降的时候,其实就已经可以准备收了。
- checkpoint 的 config.json 要检查标签映射。这是部署阶段最容易翻的车,而且翻得无声无息。
六、和这个系列其他篇的关系
- 《Qwen3-0.6B 医疗 SFT 实战》:生成任务上的过拟合(eval loss 触底后反弹)
- 《BERT 微调三种方式对比》:同任务下冻结 / LoRA / 全量的选择
- 本篇:分类任务上过拟合的另一种形态——准确率还在涨,但损失先叛变了
三篇合起来是一条完整的线:怎么训(方式)→ 训多久(轮数/早停)→ 怎么判断训坏了(指标背离)。
关于本文数据:来自 Week11/week11_output_model/bertbase/bert_emotion_classifier/checkpoint-2814 与 checkpoint-5628 下真实的 trainer_state.json(共 114 条训练日志 + 2 条验证记录),以及 checkpoint-5628/config.json。训练脚本使用 🤗 transformers Trainer。


