
手写BiLSTM-CRF医学NER:一个loss=-9930的bug复盘
本篇素材来自我 NLP 课程 Week7 的作业:
ai2-week7.py,任务是在 CMeEE-V2 上做医学命名实体识别(NER)。当时作业”交了”,半年后再打开复现,发现训练日志怎么看怎么不对。
1. 作业背景:手写 BiLSTM-CRF
CMeEE-V2 是中文医学 NER 数据集,共 15,000 条样本、9 类实体:
| 实体类型 | 说明 |
|---|---|
| bod | 身体部位 |
| dep | 科室 |
| dis | 疾病 |
| dru | 药物 |
| equ | 医疗设备 |
| ite | 医学检验项目 |
| mic | 微生物类 |
| pro | 医疗程序 |
| sym | 症状 |
原作业模型结构很清晰:
- 字符级 Embedding(128-dim)
- 2 层 BiLSTM(hidden=128)
- 手写 CRF 层:前向算法算配分函数,维特比解码求最优序列
- 优化器 Adam + ReduceLROnPlateau + early stopping(patience=5)
模型不大,参数量约 100 万,12G 显存轻松跑。
2. 复现时的惊吓:loss = -9930
我把代码重新跑起来,第一个 epoch 的输出是这样的:
1 | Epoch 01 | loss -9930.8167 | token_acc 0.7277 | entity_f1 0.1905 |
CRF 的负对数似然 loss 不可能是负的。正常初始 loss 应该在几十到几百之间(取决于序列长度和标签数)。我当时第一反应是:这模型崩了,原始作业训出来的 best_ner_model.pt 可能也是废的。
但 token_acc 有 0.7277,entity_f1 0.1905,看起来训练还在走。这说明 loss 的”形状”可能没问题,只是数值显示被平移了。
3. 定位 bug:CRF 停止转移的索引方向写反
看 CRF 前向算法最后一步的代码:
1 | alpha = alpha + self.transitions[self.STOP_TAG, :].unsqueeze(0) |
self.transitions 的形状是 (num_tags + 2, num_tags + 2),其中 num_tags + 2 是因为多加了 START 和 STOP 两个状态。
按照线性链 CRF 的定义:
transitions[i, j]= 从标签 i 转移到标签 j 的分数- 序列末尾应该加上
transitions[last_tag, STOP_TAG],即”到达 STOP”的那一列 - 而原代码写的是
transitions[STOP_TAG, :],意思是”从 STOP 出发”的那一行
初始化时这一行被设成 -10000(表示 STOP 后面不能再接标签):
1 | self.transitions[self.STOP_TAG, :] = -10000.0 |
所以原代码把每个路径的分数都多加了 -10000,导致 loss 整体偏移 -10000。
4. 用暴力枚举验证
为了确认,我写了一个最小可复现:3 个标签、序列长度 3,暴力枚举 $3^3 = 27$ 条路径,分别和两种实现对比。
| 实现 | -log P(y|x) | 与真值差 |
|—|—:|—:|
| 暴力枚举(真值) | 1.5567 | - |
| 原作业写法 transitions[STOP_TAG, :] | -9998.4434 | 10000.0000 |
| 修正写法 transitions[:, STOP_TAG] | 1.5567 | 0.0000 |
差值正好是 10000,和初始化时填的非法转移惩罚值一致。问题定位。
5. 关键发现:这个 bug 其实”无害”
定位到 bug 之后,我原本以为要推翻整个原始训练。但仔细想了一下:CRF 的 loss 是
$$
\mathcal{L} = \log \sum_{y’} \exp(s(x, y’)) - s(x, y)
$$
如果 STOP_TAG 那一行对所有路径都加同一个常数 $-10000$,那么配分函数 $\log\sum\exp$ 会变小 10000,而真实路径分数 $s(x,y)$ 也会变小 10000。两者相减,loss 的差值不变。
也就是说:
- 梯度不变:模型学到的参数和修正版一样
- 维特比解码不变:argmax 对 uniform 平移不敏感
- 只有 loss 的显示值错了:看起来是 -9930,实际应该在 +69 附近(修复版第 1 epoch 验证 loss 正好是 69.49,二者差正好约 10000)
这一点我自己都很意外。我把修复版和原写法都跑起来,对比它们的 entity F1 曲线,果然几乎重合(修复版 best 0.3863,原写法 0.3789)。
6. 三模式实验:CRF 到底值多少 F1?
为了讲清楚这件事,我补跑了三组实验:
| 模式 | 说明 |
|---|---|
crf | 修正 STOP 转移后的 BiLSTM-CRF |
crf_legacy | 保留原作业的 transitions[STOP_TAG, :] |
softmax | 去掉 CRF,直接用 CrossEntropy + argmax |
三组共用同一套数据、同一套超参(seed=42、batch=32、max_len=128、LR=1e-3、30 epoch、早停 patience=5)。
6.1 entity F1 与 token accuracy 曲线
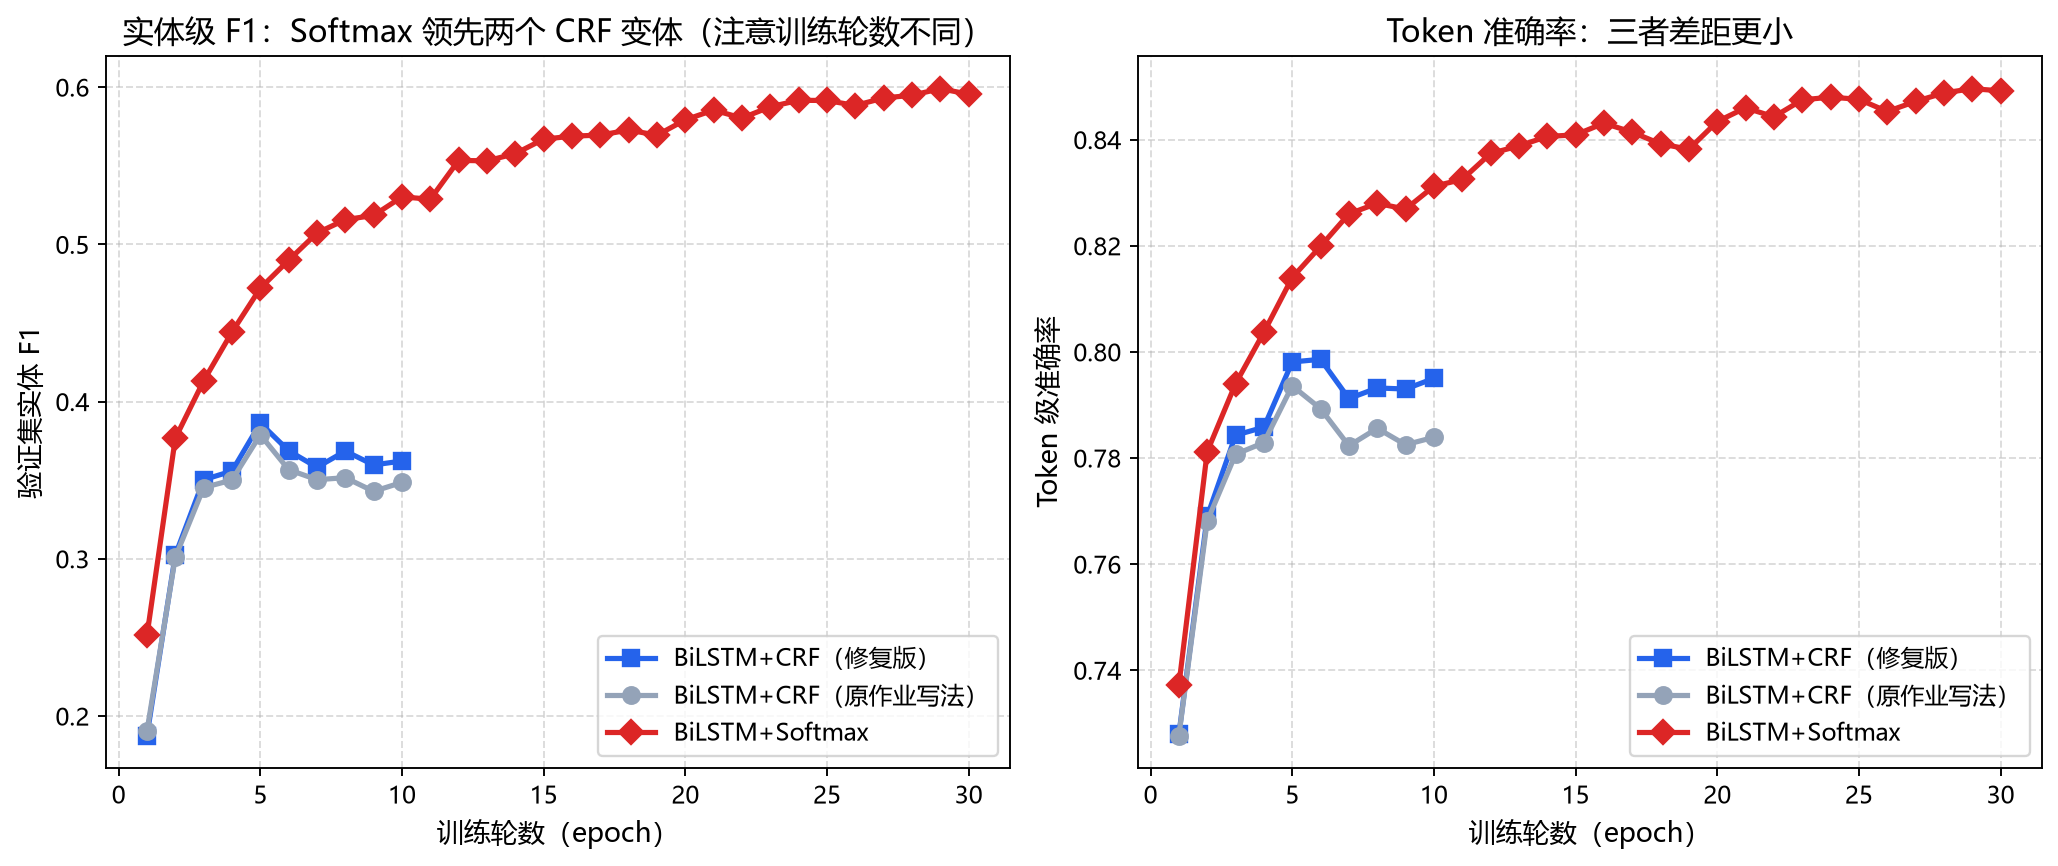
三组的 best entity F1 见下表,都在 dev 集上取:
| 模式 | best entity F1 | 取得轮数 | best token_acc |
|---|---|---|---|
crf(修复版) | 0.3863 | 第 5 epoch | 0.795 |
crf_legacy(原作业写法) | 0.3789 | 第 5 epoch | 0.784 |
softmax(无 CRF) | 0.5990 | 第 29 epoch | 0.849 |
这里有两个必须老实说的前提,否则结论会误导人:
- 训练预算不对称。 两个 CRF 模式在第 5 epoch 拿到最佳后就被早停了(patience=5),所以曲线只有 10 个点;而 Softmax 跑满 30 epoch 还在涨。换句话说,Softmax 多训了约 3 倍的时间。
- CRF 更早过拟合。 看
crf的曲线:第 5 epoch 之后 train loss 一路从 18.46 降到 10.31,但 entity F1 反而从 0.3863 掉到 0.3622——典型的过拟合信号。
所以这张图**不能干净地证明”Softmax 比 CRF 好”**,只能说:在我这套超参和训练预算下,手写 CRF 没能追平 Softmax,而且更早过拟合。要想公平比较,得给 CRF 同样的 30 epoch + 更强的正则。这一点我放在第 7 节再展开。
6.2 loss 曲线:legacy 版整体平移
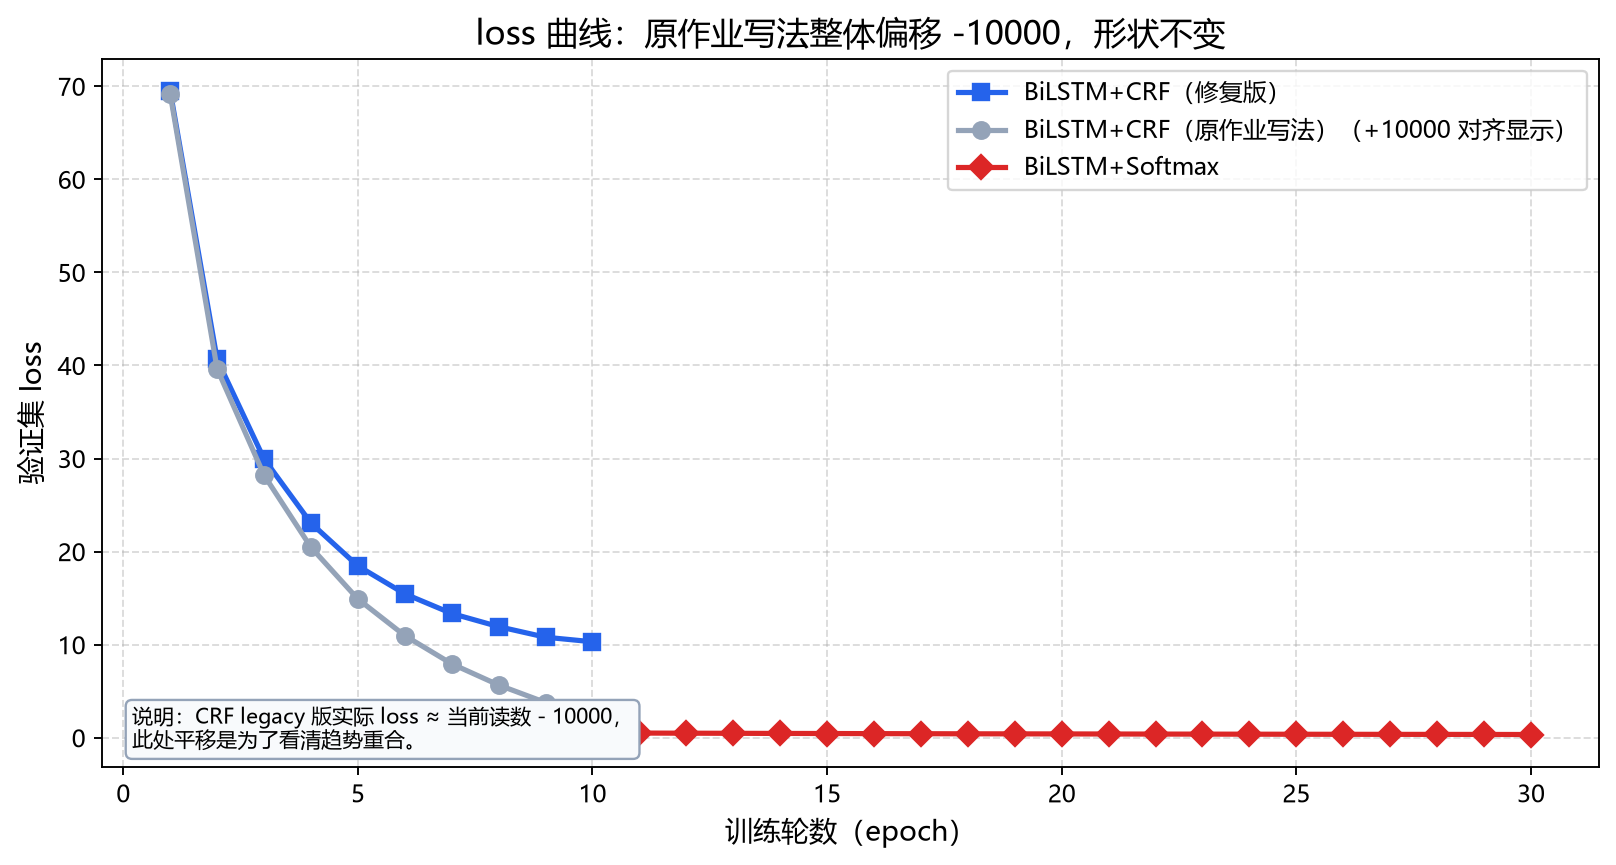
这张图就是第 3 节那个 bug 的可视化证据:crf_legacy 的 loss 整条比修复版低了大约 10000(第 1 epoch 差 10000.3,后期因为 STOP 转移参数在训练中被优化,偏移漂移到约 10007,但形状完全一致)。我把 legacy 上移 10000 后才放进同一坐标轴——平移后可以看到,修正版与 legacy 版的 loss 下降曲线、拐点、最终位置几乎重合。
这再次印证了第 5 节的结论:那个 -10000 偏移对所有路径是均匀的,只污染了 loss 的显示值(legacy 读数在 -9997 附近,真实值约 +3~+69,取决于 epoch),不影响梯度、不影响维特比解码、也不影响最终实体 F1。
6.3 分类别 F1
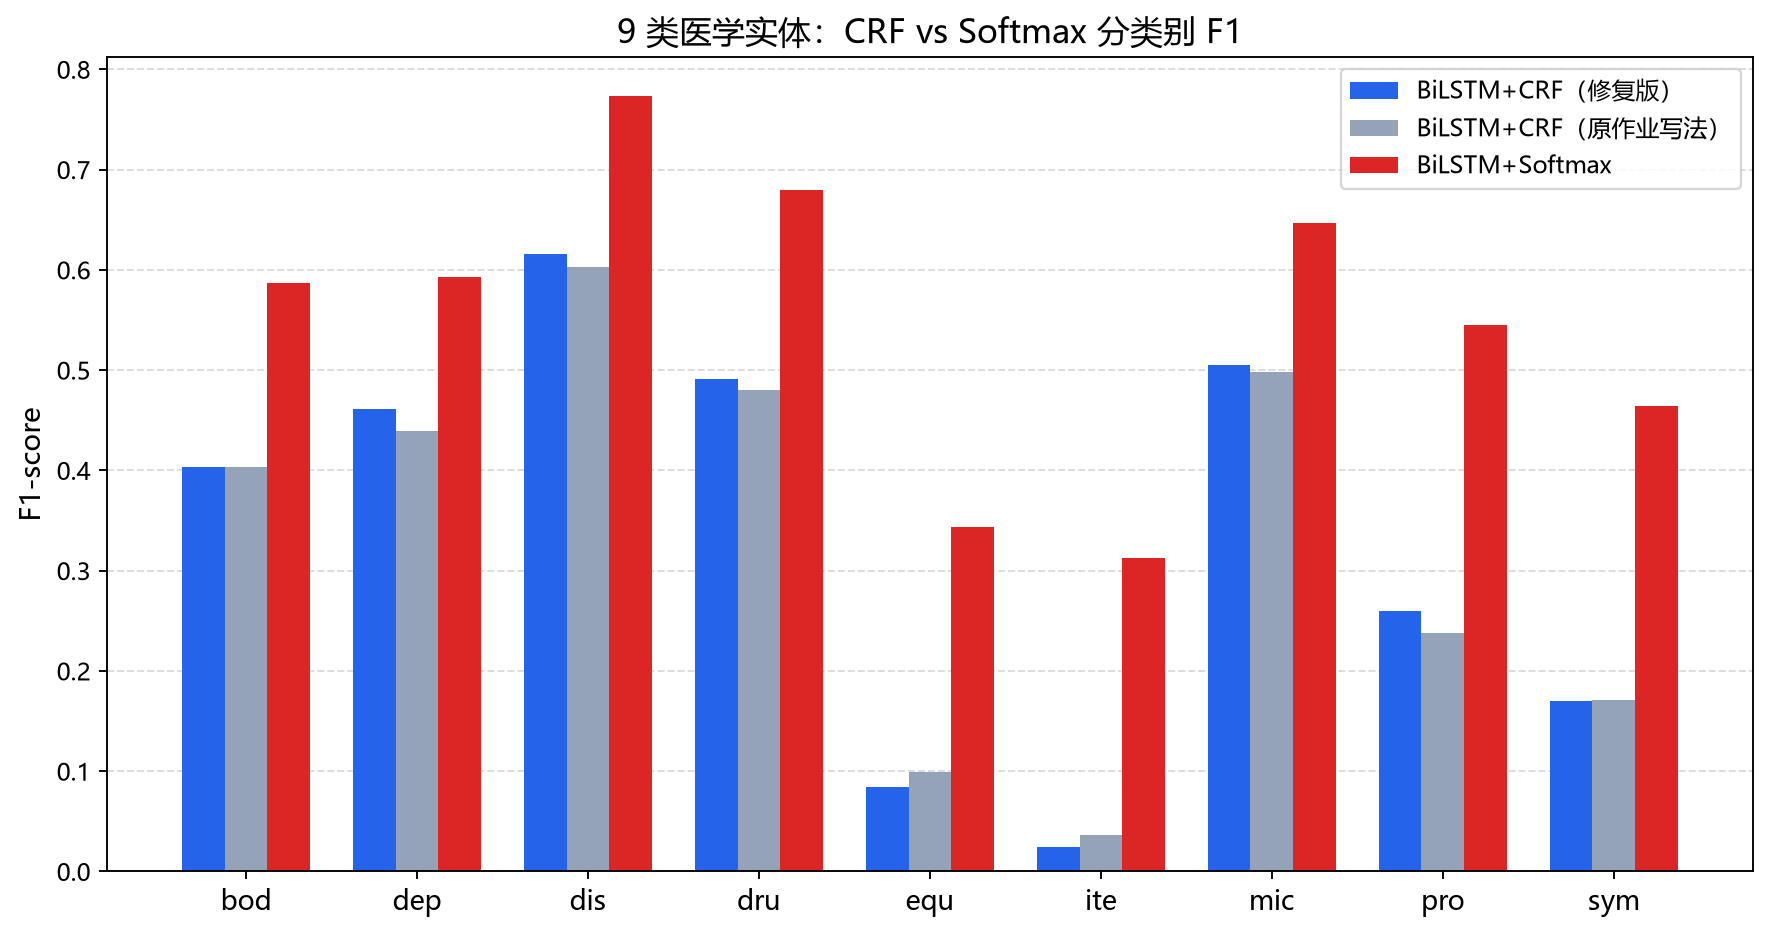
逐类看更扎心:Softmax 在全部 9 个实体类型上都超过了两个 CRF 变体,而且不是小胜:
| 类型 | Softmax F1 | CRF(修复) F1 | 差值 |
|---|---|---|---|
| dis(疾病) | 0.773 | 0.616 | +0.157 |
| pro(医疗程序) | 0.545 | 0.260 | +0.285 |
| sym(症状) | 0.465 | 0.170 | +0.295 |
| bod(身体部位) | 0.587 | 0.404 | +0.183 |
| mic(微生物) | 0.647 | 0.505 | +0.142 |
| dru(药物) | 0.680 | 0.491 | +0.189 |
| dep(科室,样本仅 24) | 0.593 | 0.462 | +0.131 |
| equ(设备,样本 122) | 0.343 | 0.084 | +0.259 |
| ite(检验项目,样本 217) | 0.313 | 0.024 | +0.289 |
连样本极少的 dep(support=24)和稀疏的 equ/ite,Softmax 也都领先。这说明在这个 9 类医学 NER 任务上,我手写的 CRF 不仅没帮上忙,反而系统性地拖累了每一类。
为什么会这样?这是需要继续验证的假设,不是定论:(1) 训练预算不对称,Softmax 多训了约 20 个 epoch;(2) CRF 的转移矩阵在稀疏类型(equ、ite)上几乎学不到有效约束,反而引入噪声;(3) 全局归一化的 CRF 在样本不够时比逐 token 的 Softmax 更容易过拟合转移参数。无论哪种,结论都指向同一句话——**不要默认”加了 CRF 一定更好”**。
7. 工程上值得记住的两点
(1)PyTorch 升级会让旧代码出现奇怪的”看起来崩溃”
原作业在原环境下应该能正常显示 loss,因为当时的 PyTorch 版本里 .squeeze(dim) 的行为刚好把张量维度压对了。我换到 PyTorch 2.12 后,手写 _log_sum_exp 里的 .squeeze(dim) 不再稳定生效,损失函数先爆维度,间接暴露了 STOP 转移方向的问题。教训:凡是自己手写的 CRF/BeamSearch/Viterbi,都要用一个小规模暴力枚举做单元测试。
(2)不要默认”加了 CRF 一定更好”——这次它反而拖了后腿
我原本的假设是:CRF 的全局归一化能约束标签转移的合法性,应该会让实体边界更准、entity F1 更高。但数据打了脸:在这个任务上,去掉 CRF 的 Softmax 在 token_acc(0.849 vs 0.795,差 0.054)和 entity_f1(0.599 vs 0.386,差 0.213)上双双领先,而且 9 个类型全胜。注意 entity F1 的差距远大于 token 准确率——这正好印证 NER 里 token 级和实体级评估不是一回事:一个 B- 标错成 I-,token 只扣 1 分,整条实体却没了。即便如此,CRF 在这里既没保住 token 也没保住实体。
更要命的是,CRF 更早过拟合(第 5 epoch 后 entity F1 不升反降)。所以”CRF 提升 NER”不是一个放之四海皆准的结论,它取决于数据量、训练预算、正则力度。如果你要复现这个实验,请务必给 CRF 和 Softmax 相同的训练轮数 + 早停策略再下结论——我这里因为早停,CRF 只训了 10 epoch,这是个不公平的对比,我自己也写在这里。
8. 复现实验
1 | # 三模式顺序跑(输出在 D:\tmp_ner) |
如果你只关心 CRF 正确性验证,可以跑最小脚本:
1 | python week7_ner.py --mode crf --epochs 1 --out-dir /tmp/ner_crf |
然后对比两个 history.json 里的 loss:数值差应约为 10000,但 token_acc / entity_f1 基本一致。
9. 和前面文章的呼应
这篇和最近写的两篇也能连起来读:
- NLP 文本分类标准项目流程(Week3) —— 同一个课程里更早的基础实验
- BERT 文本分类微调实录:从 checkpoint 里读出过拟合的另一种信号 —— 同样是从训练曲线里读出模型状态
- BERT+稀疏MoE实战 —— 上一篇,和这篇一起覆盖了”分类 + 序列标注”两个基础 NLP 任务
结论:半年前的代码里藏着一个会让 loss 显示为 -9930 的 bug,但它没有破坏训练,只是吓唬人。真正让我长教训的是两件事:
第一,不要只相信 loss 数值,要同时看 token_acc、entity_f1,以及最重要的——用暴力枚举验证自己手写的概率计算。
第二,不要默认某个”标准组件”一定有用。我本以为 CRF 会提升 NER,结果它在这个任务上反而全面落后于一个朴素的 Softmax 头。架构选择必须实测,而且要在相同训练预算下实测。

