
中文文本纠错实战:BiLSTM 逐位置纠错,四个优化器差出 35 倍
经验驱动。这是一次在 CPU 上跑完的中文拼写纠错实验:字符级 BiLSTM,逐位置判断”这个字对不对、不对该换成什么”。最值得看的不是模型,是四个优化器的差距——同样结构、同样数据、同样 3 个 epoch,SGD 的字符准确率 0.0262,Adam 是 0.9200,差 35 倍。本文所有数字来自本机真实训练日志。
一、任务怎么建模成”逐位置纠错”
中文纠错有个方便的地方:错字和正字长度一样。”肾嚢肿”和”肾囊肿”都是 3 个字,所以可以当成序列标注任务来做,不需要对齐、不需要编辑距离。
所以做法是:
- 输入:原始句子(可能含错字)
- 输出:每个位置一个”应该是哪个字”的预测
- 标签:正确句子对应位置的字符
- 损失:只在真正含错字的负样本上算,且只算错别位置
这样模型学到的是”给定上下文,这个位置最可能是什么字“,而不是死记硬背。
二、实验设置
| 项目 | 值 |
|---|---|
| 模型 | 字符级 BiLSTM |
| 硬件 | CPU(本机 Python 3.10) |
| 数据 | chinese_text_correction(已通过 hf-mirror 下载到本地) |
| 小规模对比 | train 8000 / val 1000,3 epoch |
| 大规模验证 | train 12000 / val 1500,5 epoch |
| 对比变量 | 只换优化器,模型结构和数据切分完全相同 |
三、核心结果:优化器选错,3 个 epoch 基本白跑
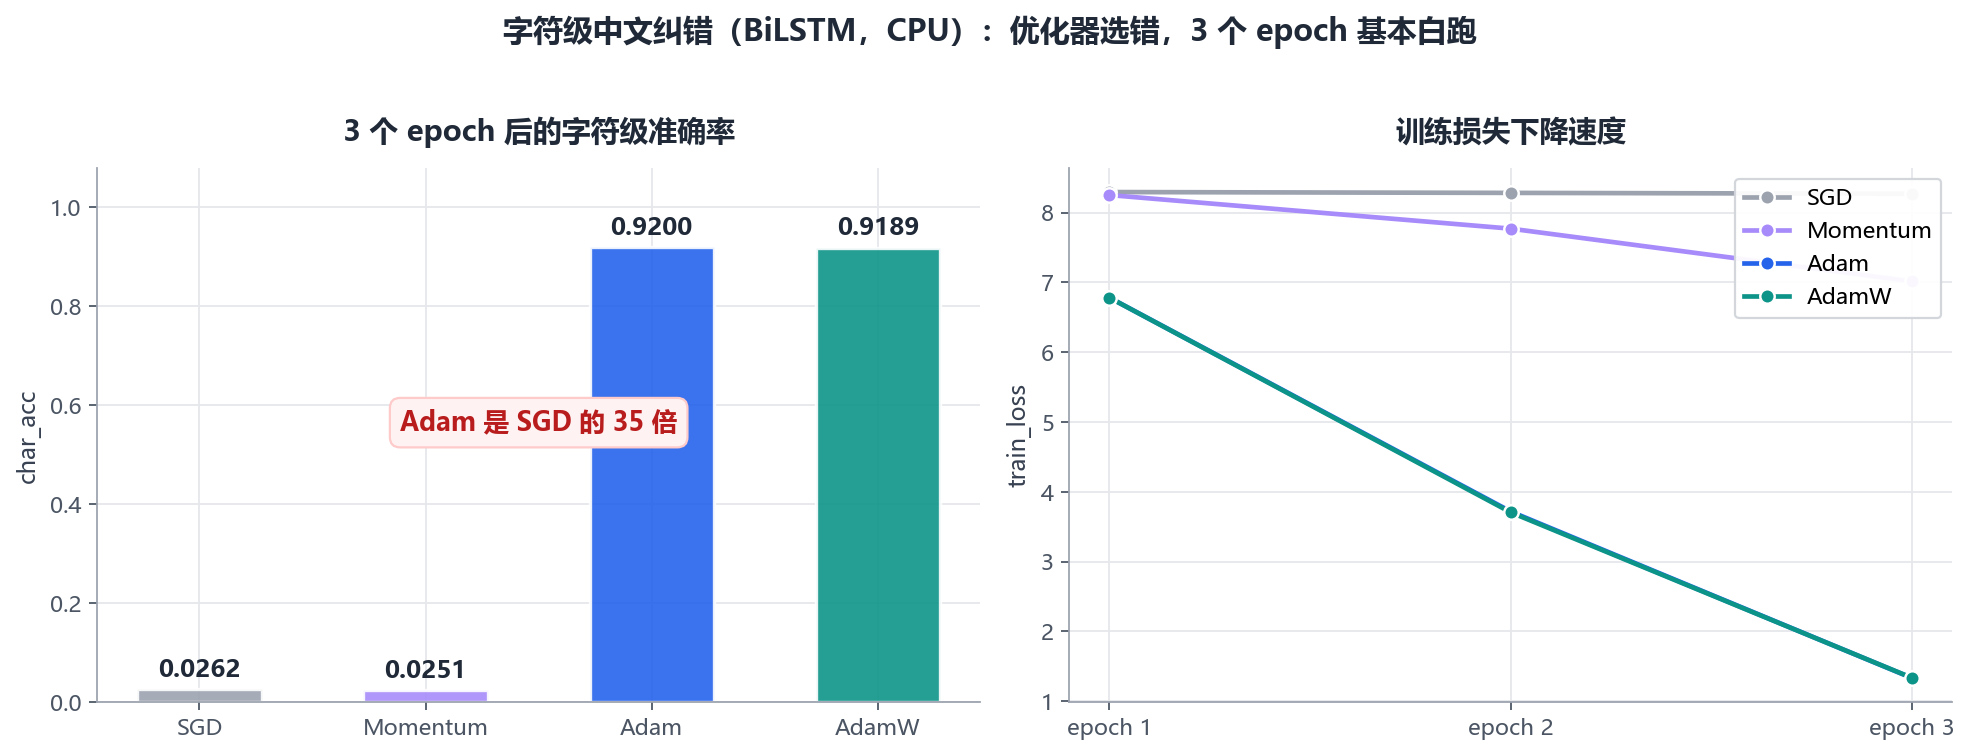
小规模实验(train 8000 / val 1000 / 3 epoch)的完整日志:
1 | SGD epoch 1 train=8.2954 val=8.2889 char=0.0000 sent=0.0000 |
| 优化器 | 3 epoch 后 char_acc | sent_acc | train_loss |
|---|---|---|---|
| SGD | 0.0262 | 0.0000 | 8.2710 |
| Momentum | 0.0251 | 0.0000 | 7.0145 |
| Adam | 0.9200 | 0.2500 | 1.3295 |
| AdamW | 0.9189 | 0.2390 | 1.3316 |
Adam 的字符准确率是 SGD 的 35 倍。 而且注意 SGD 和 Momentum 的 sent_acc 是 0.0000——3 个 epoch 下来一个整句都没纠对过。它们的 train_loss 还停在 8.27 和 7.01,根本没收敛。
为什么会差这么多
字符级纠错的标签分布极度不均衡:一句话 30 个字,可能只有 1 个是错的。也就是说 **97% 的位置标签是”保持原样”**。
SGD 在这种分布下会发现一件”取巧”的事:全部预测”不改”就能拿到 97% 的准确率,梯度信号太弱,它没有动力去学那 3% 的修正。而 Adam 的自适应学习率放大了稀疏但有信息量的梯度,所以能钻进去。
四、放大数据量之后
把数据扩到 train 12000 / val 1500、跑 5 个 epoch:
1 | epoch 1 train_loss 5.5708 |
这组数字暴露了一个必须诚实说出来的问题:
- 730 个真正含错字的句子里,整句完全改对的是 0 个(
negative_exact_rate = 0.0) - 但
negative_changed_positions_all_correct = 0.1027——约 10.27% 的句子,模型把所有错误位置都改对了
两个数字放一起,结论很清楚:模型确实学会了改错,但它会顺手改坏一些原本正确的位置。所以”每个错字都改对”和”整句完全正确”之间还隔着一大截。
五、真实纠错样例
这些是训练过程中真正修正成功的例子:
| 原句(含错) | 模型输出 | 正确句子 |
|---|---|---|
| 惟有信念才能使我们明白人生的价值… | 唯有信念才能使我们明白人生的价值… | 唯有信念才能… |
| 肾嚢肿穿刺后疼痛多久 | 肾囊肿穿刺后疼痛多久 | 肾囊肿穿刺后疼痛多久 |
| 尿捡细菌多少算正常值 | 尿检细菌多少算正常值 | 尿检细菌多少算正常值 |
| 右膝骨姓关节炎的护理措施 | 右膝骨性关节炎的护理措施 | 右膝骨性关节炎的护理措施 |
四个案例全是同音字或形近字替换(惟/唯、嚢/囊、捡/检、姓/性),这正是中文纠错最难的一类——错字和正字读音甚至字形都接近,只能靠上下文语义区分。
六、这次实验学到的四件事
- **不均衡标签的任务,先想清楚”梯度信号从哪来”**。97% 的位置是”不改”,模型有强烈动机躺平。SGD/Momentum 在这里直接躺平,Adam 能爬起来。
- 不要用 accuracy 一个指标判断收敛。SGD 的 char_acc 0.0262 看着不是 0,但 sent_acc 是 0.0000——从产品角度它一个都没修对。任务相关指标(整句正确率)才是验收标准。
- BiLSTM 方案有上限。10.27% 的”错字全改对”但 0% 的”整句正确”,说明它缺少对语言的长程理解。要继续提升,应该换预训练中文模型(BERT/MacBERT 这类,本身就有掩码预训练的先验)。
- CPU 不是不能做实验。这次全程 CPU,3 个 epoch 的小规模对比几分钟就跑完,足够支撑”换优化器”这个决策。先在小规模上把优化器和结构定下来,再上 GPU 跑大的。
七、复现方式
1 | python train_correction_bilstm.py \ |
关于本文数据:全部来自 Week9/chinese_correction_bilstm_results.ipynb 中保留的本机真实运行日志(Python 3.10 / CPU),以及 train_correction_bilstm.py。未做任何数值修饰。


