
唐诗生成实验:三个 GPT-2 与五种解码策略的真实差距
经验驱动。同一份唐诗数据、同样的训练参数,微调三个不同的中文 GPT-2,然后用五种解码策略各生成一批,一共 60 条真实生成结果。结论有点反直觉:模型选对比解码策略影响更大——困惑度从 87.9 到 13.3 差了 6.6 倍,而换解码策略带来的变化主要在”长度和多样性”,不在”像不像诗”。
一、实验设计
三个模型都用中文词表(避免英文 GPT-2 的 byte-level tokenizer 把汉字切得太碎):
| 模型 | 参数量 | 说明 |
|---|---|---|
uer/gpt2-distil-chinese-cluecorpussmall | 59.5M | 轻量版 |
uer/gpt2-chinese-cluecorpussmall | 102M | 标准版 |
uer/gpt2-chinese-poem | 103M | 针对中国古诗预训练 |
五种解码策略:greedy、beam_search、top_k、top_p、top_k_top_p。
输入格式统一为 [CLS]诗名[SEP]句首,比如 [CLS]静夜思[SEP]床前,让模型续写。
硬件:本机 RTX 2060,PyTorch 2.9.0+cu130,Transformers 4.57.1。
二、先看模型差距:困惑度说明一切
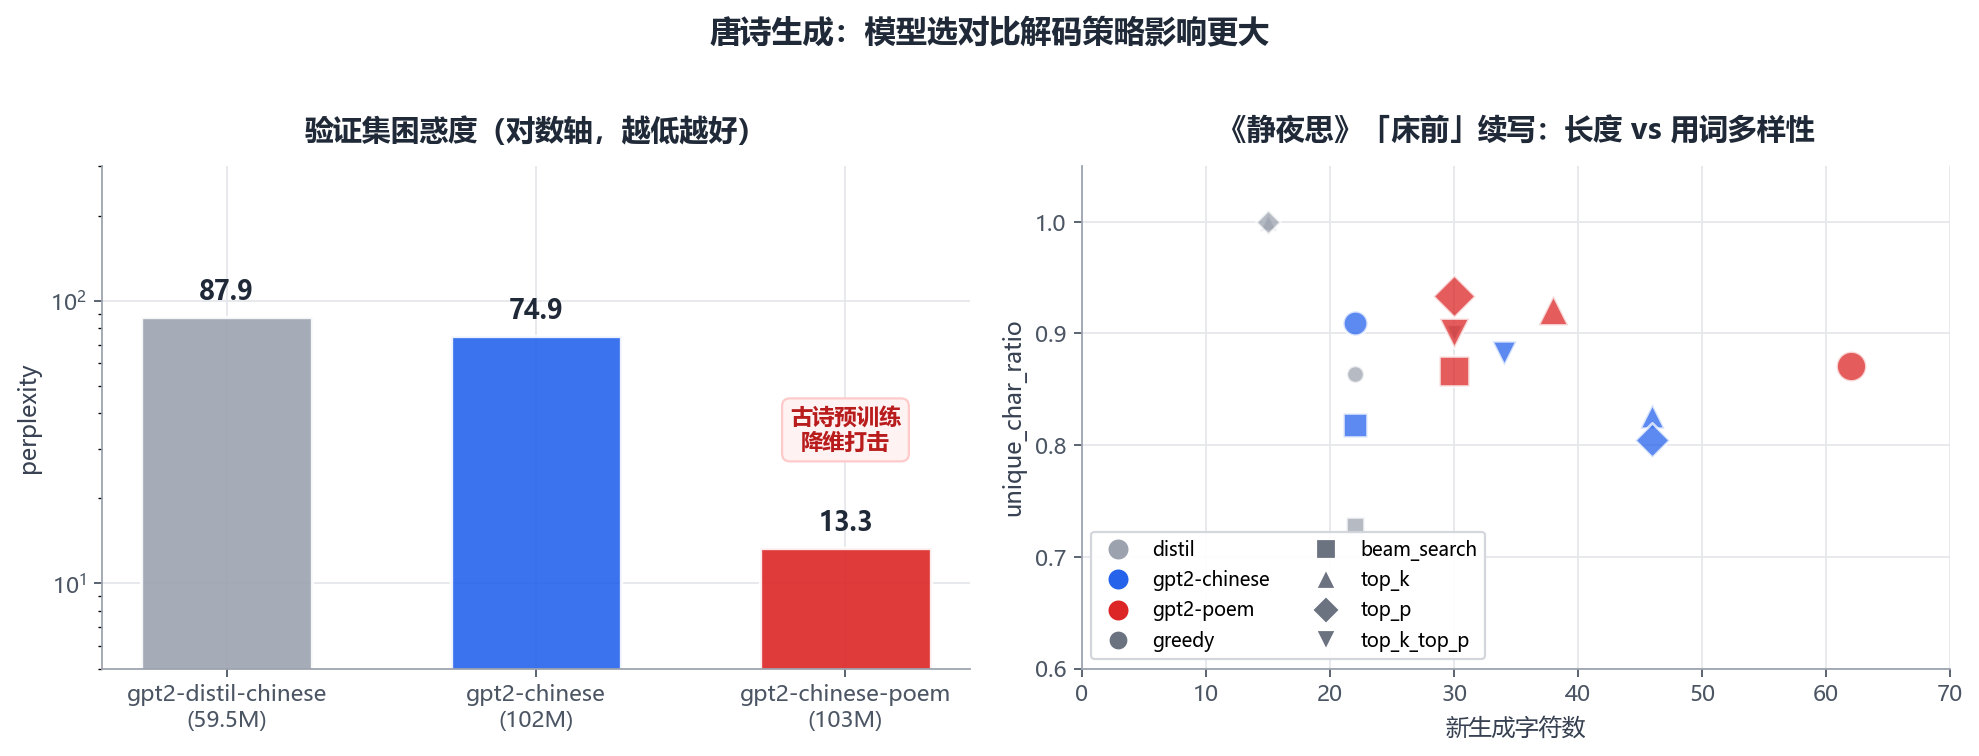
| 模型 | 参数量 | 训练耗时 | eval_loss | perplexity |
|---|---|---|---|---|
| gpt2-distil-chinese | 59.5M | 508 s | 4.4761 | 87.89 |
| gpt2-chinese | 102M | 963 s | 4.3162 | 74.91 |
| gpt2-chinese-poem | 103M | 1057 s | 2.5901 | 13.33 |
第三个模型的困惑度只有前两个的 1/6 到 1/7。 这不是训练技巧的胜利,是领域预训练的胜利——gpt2-chinese-poem 在训练前就已经读过大量古诗,微调只是让它适应我们的数据格式。
注意一个细节:参数量几乎没变(102M → 103M),困惑度却降了 5.6 倍。所以在垂直领域,”用什么数据预训练的”比”模型多大”重要得多。
三、再看解码策略:主要影响长度和多样性
同一模型、同一题目(《静夜思》「床前」)下,五种策略的真实输出对比。
gpt2-chinese-poem(质量最好那个)
| 策略 | 新字符数 | 去重率 | 续写内容 |
|---|---|---|---|
| greedy | 62 | 0.87 | 一朵红芙蓉,半露颜色香且浓。美人临镜梳白发,满头自觉双鸾同。秋来独坐愁见影,玉阶草深红日冷。… |
| beam_search | 30 | 0.87 | 蟋蟀鸣秋砌,窗下蜘蛛挂晚灯。无限客愁谁解遣,一条丝发一条冰。 |
| top_k | 38 | 0.92 | 不平鸣玉琴,弦冷曲高谁听音。何事人间无郑卫?弹成一曲肠断时,江南日暮寒风起。 |
| top_p | 30 | 0.93 | 不平鸣玉琴,弦上有声多古音。何事若人无此曲,弹成一字千般心。 |
| top_k_top_p | 30 | 0.90 | 不见旧相思,梦里分明似太痴。几度欲来眠不得,又因卧病立多时。 |
gpt2-distil-chinese(轻量那个)
| 策略 | 新字符数 | 去重率 | 续写内容 |
|---|---|---|---|
| greedy | 22 | 0.86 | 月色满,窗外月光明。夜深无事处,独坐一杯清。 |
| beam_search | 22 | 0.73 | 一夜月,窗外一夜风。不知何处去,何处是人间。 |
| top_k | 15 | 1.00 | 不见枕头闲,梦里常说话咽人声。 |
| top_p | 15 | 1.00 | 不见枕头闲,梦里常说话咽人声。 |
几个一眼能看出的规律
- beam_search 在差模型上会放大重复。
gpt2-distil-chinese的 beam 版去重率只有 0.73,”一夜月,窗外一夜风。不知何处去,何处是人间”——“一夜”出现两次、”何处”出现两次。beam search 追求高概率路径,而高概率路径往往是套路化重复。 - top_k / top_p 在差模型上反而更短。轻量模型下它们只生成 15 个字(greedy 有 22 个)。因为采样一旦采到低概率字,很容易撞上
<EOS>提前结束。 - greedy 在好模型上最长。
gpt2-chinese-poem的 greedy 一口气写了 62 个字,因为古诗预训练让”继续写”的概率一直很高。 - 从全体 60 条看,策略对长度的影响是稳定的:平均新字符数 greedy 25.3 < beam_search 30.0 < top_k_top_p 35.6 < top_k 36.8 ≈ top_p 37.4。采样策略普遍比贪心策略写得更长。
四、人工评审模板:光看指标不够
实验里还准备了一份人工评审表(human_review_template.csv),字段是:
1 | model, title, opening, strategy, continuation, |
三个 1~5 分的维度:格式(平仄/对仗/句长)、连贯性(意思是否通顺)、意象(是否有画面感)。
为什么要人工评:上面那些自动指标(长度、去重率、困惑度)**没有一个能直接衡量”像不像诗”**。比如 greedy 写了 62 个字,但”玉阶草深红日冷”这种句子意象是乱的。反过来 beam_search 只有 30 字,却”蟋蟀鸣秋砌,窗下蜘蛛挂晚灯”对仗工整。
自动指标告诉你”生成了什么”,人工评审才能告诉你”好不好”。
五、这次实验的三个可复用结论
- 垂直领域先找领域预训练模型。
gpt2-chinese-poem用几乎相同的参数量拿到 1/6 的困惑度,这是任何训练技巧都换不来的。做古文、诗词、医学、法律,先搜有没有对应领域的预训练模型。 - 解码策略按”模型好坏”区别选择。模型强的时候 greedy 就够用且最长;模型弱的时候 greedy 容易套路化,可以试 top_p 增加多样性,但要接受它可能提前结束。
- beam_search 不是万能药。它在机器翻译上有效,但在中文古诗生成上明显放大了重复(去重率掉到 0.73)。换任务必须重新验证,不能默认套用。
六、还没解决的事
- 60 条生成结果的人工评审只搭了模板,没有填完——所以本文的所有判断都基于自动指标 + 肉眼观察,缺少量化的人工分。这是这篇最大的短板。
- 只试了三种模型、五种策略,没有做温度系数的扫描。
- 评测集是 4 个诗名 × 1 个句首,样本偏小,结论适合当方向性参考。
关于本文数据:来自 Week12/model_week12/ 下的 training_comparison.csv(3 个模型的训练指标)、generation_comparison.csv(60 条生成的完整记录,含耗时、新字符数、去重率)、loss_comparison.png 与 human_review_template.csv。实验代码为课程参考解法 参考答案.ipynb,数据路径原指向 poetry.txt。

